




Нейросеть для создания музыки выдаёт готовый трек быстрее, чем автор успевает открыть каталог стоковых библиотек, и ровно на этом простая часть заканчивается. Трек уходит в монтаж, где уже лежит дорожка закадрового текста, — и выясняется, что по отдельности звучат обе, а вместе получается плотное полотно, из которого половину слов приходится вытаскивать вслушиванием.
В выдаче по теме почти всё написано про одно: как получить трек. Вопрос, который реально стоит перед автором ролика, другой — как этот трек уживётся с речью. Ниже разбирается именно он: где фон обязателен, где крадёт разборчивость, что писать в запросе, чтобы вышла музыка под голос, и как выставить уровни так, чтобы диктор остался главным.
Проверять описанное удобнее на своём материале: собрать дикторскую дорожку под будущий фон стоит до того, как выбран трек, — и это единственный правильный порядок.
В статье:
- по каким форматам фон обязателен, а где он вредит;
- анатомия запроса: настроение, темп, инструменты, длительность, структура;
- почему вокал в фоне спорит с закадровым голосом;
- частоты, плотность аранжировки и автоматическое приглушение;
- уровни и тайминг: вступление, уход, хвост в конце ролика;
- права на музыку, условия сервисов и паспорт ролика;
- таблица «формат — нужен ли фон — какой подходит — типичная ошибка»;
- чек-лист сдачи ролика на девять пунктов.
Нейросеть для создания музыки: зачем ролику фон и когда он мешает
Фоновая музыка выполняет в ролике три работы. Склеивает монтажные куски, чтобы стыки не воспринимались как обрыв. Задаёт темп восприятия: под ритмичную подложку фраза читается как энергичная, под тянущуюся — как вдумчивая. И закрывает паузы, потому что тишина между фразами ощущается длиннее, чем есть.
Вредит фон там, где перехватывает внимание. Слушатель не может одновременно следить за смыслом слов и за мелодией: как только музыкальная линия становится интересной, речь уходит на второй план и превращается в бубнёж. Так теряются номер телефона в рекламе, определение в уроке, название улицы в аудиогиде.
Отсюда рабочий критерий. Хороший фон под озвучку скучен, если слушать его отдельно. Это не недостаток, а требование: у него нет собственного сюжета, потому что сюжет несёт голос.
Реклама, обучение и подкаст: сколько музыки выдерживает формат
Рекламный аудиоролик. Фон обязателен. Тридцать секунд чистой речи в эфире звучат как объявление на вокзале. Музыка формирует характер бренда за первые две секунды, до того как прозвучало первое слово. Требования жёсткие: узнаваемое начало, ровная середина под текст, внятная точка в конце. Как это делается с полным продакшеном, видно в разделе изготовление рекламных аудиороликов со сценарием и сведением.
Обучающий модуль. Фон нужен дозированно и тише, чем кажется автору. Урок слушают ради содержания, часто с конспектом и на ускорении. Подложка уместна на заставке, на переходах между темами и на титрах, а под определениями, формулами и перечислениями её лучше убирать совсем.
Подкаст и интервью. Музыка живёт в шапке и в отбивках. Под живой разговор её не кладут: реплики неровные по громкости и накладываются, любой постоянный фон превращает выпуск в беседу в кафе. Исключение — короткая подложка под авторское вступление, записанное отдельно.
Видео на канале. Здесь фон решает монтаж: под быструю нарезку музыка держит темп, под спокойный разбор мешает. Подложка включается там, где на экране что-то происходит без слов, и уходит там, где начинается объяснение.
Форматы, в которых от музыки лучше отказаться
Есть контент, где отсутствие фона — не экономия, а решение.
Аудиогид. Слушатель идёт по маршруту, вокруг шум улицы или гулкий зал, полоса восприятия уже занята. Подложка бьётся с окружающей средой и съедает то, ради чего гид включён: названия, даты, имена. Максимум допустимого — короткая тема на входе в раздел маршрута. Как устроены такие проекты, видно на странице записи аудиогидов для музеев и маршрутов.
Голосовое меню и автоответчик. Абонент ждёт цифру, которую надо нажать. Мелодия под голосом увеличивает число ошибочных нажатий и повторных прослушиваний.
Инструкции и техника безопасности. Цена непонятого слова высока, а фон всегда добавляет вероятность, что слово будет пропущено.
Что просить у нейросети для создания музыки: анатомия запроса
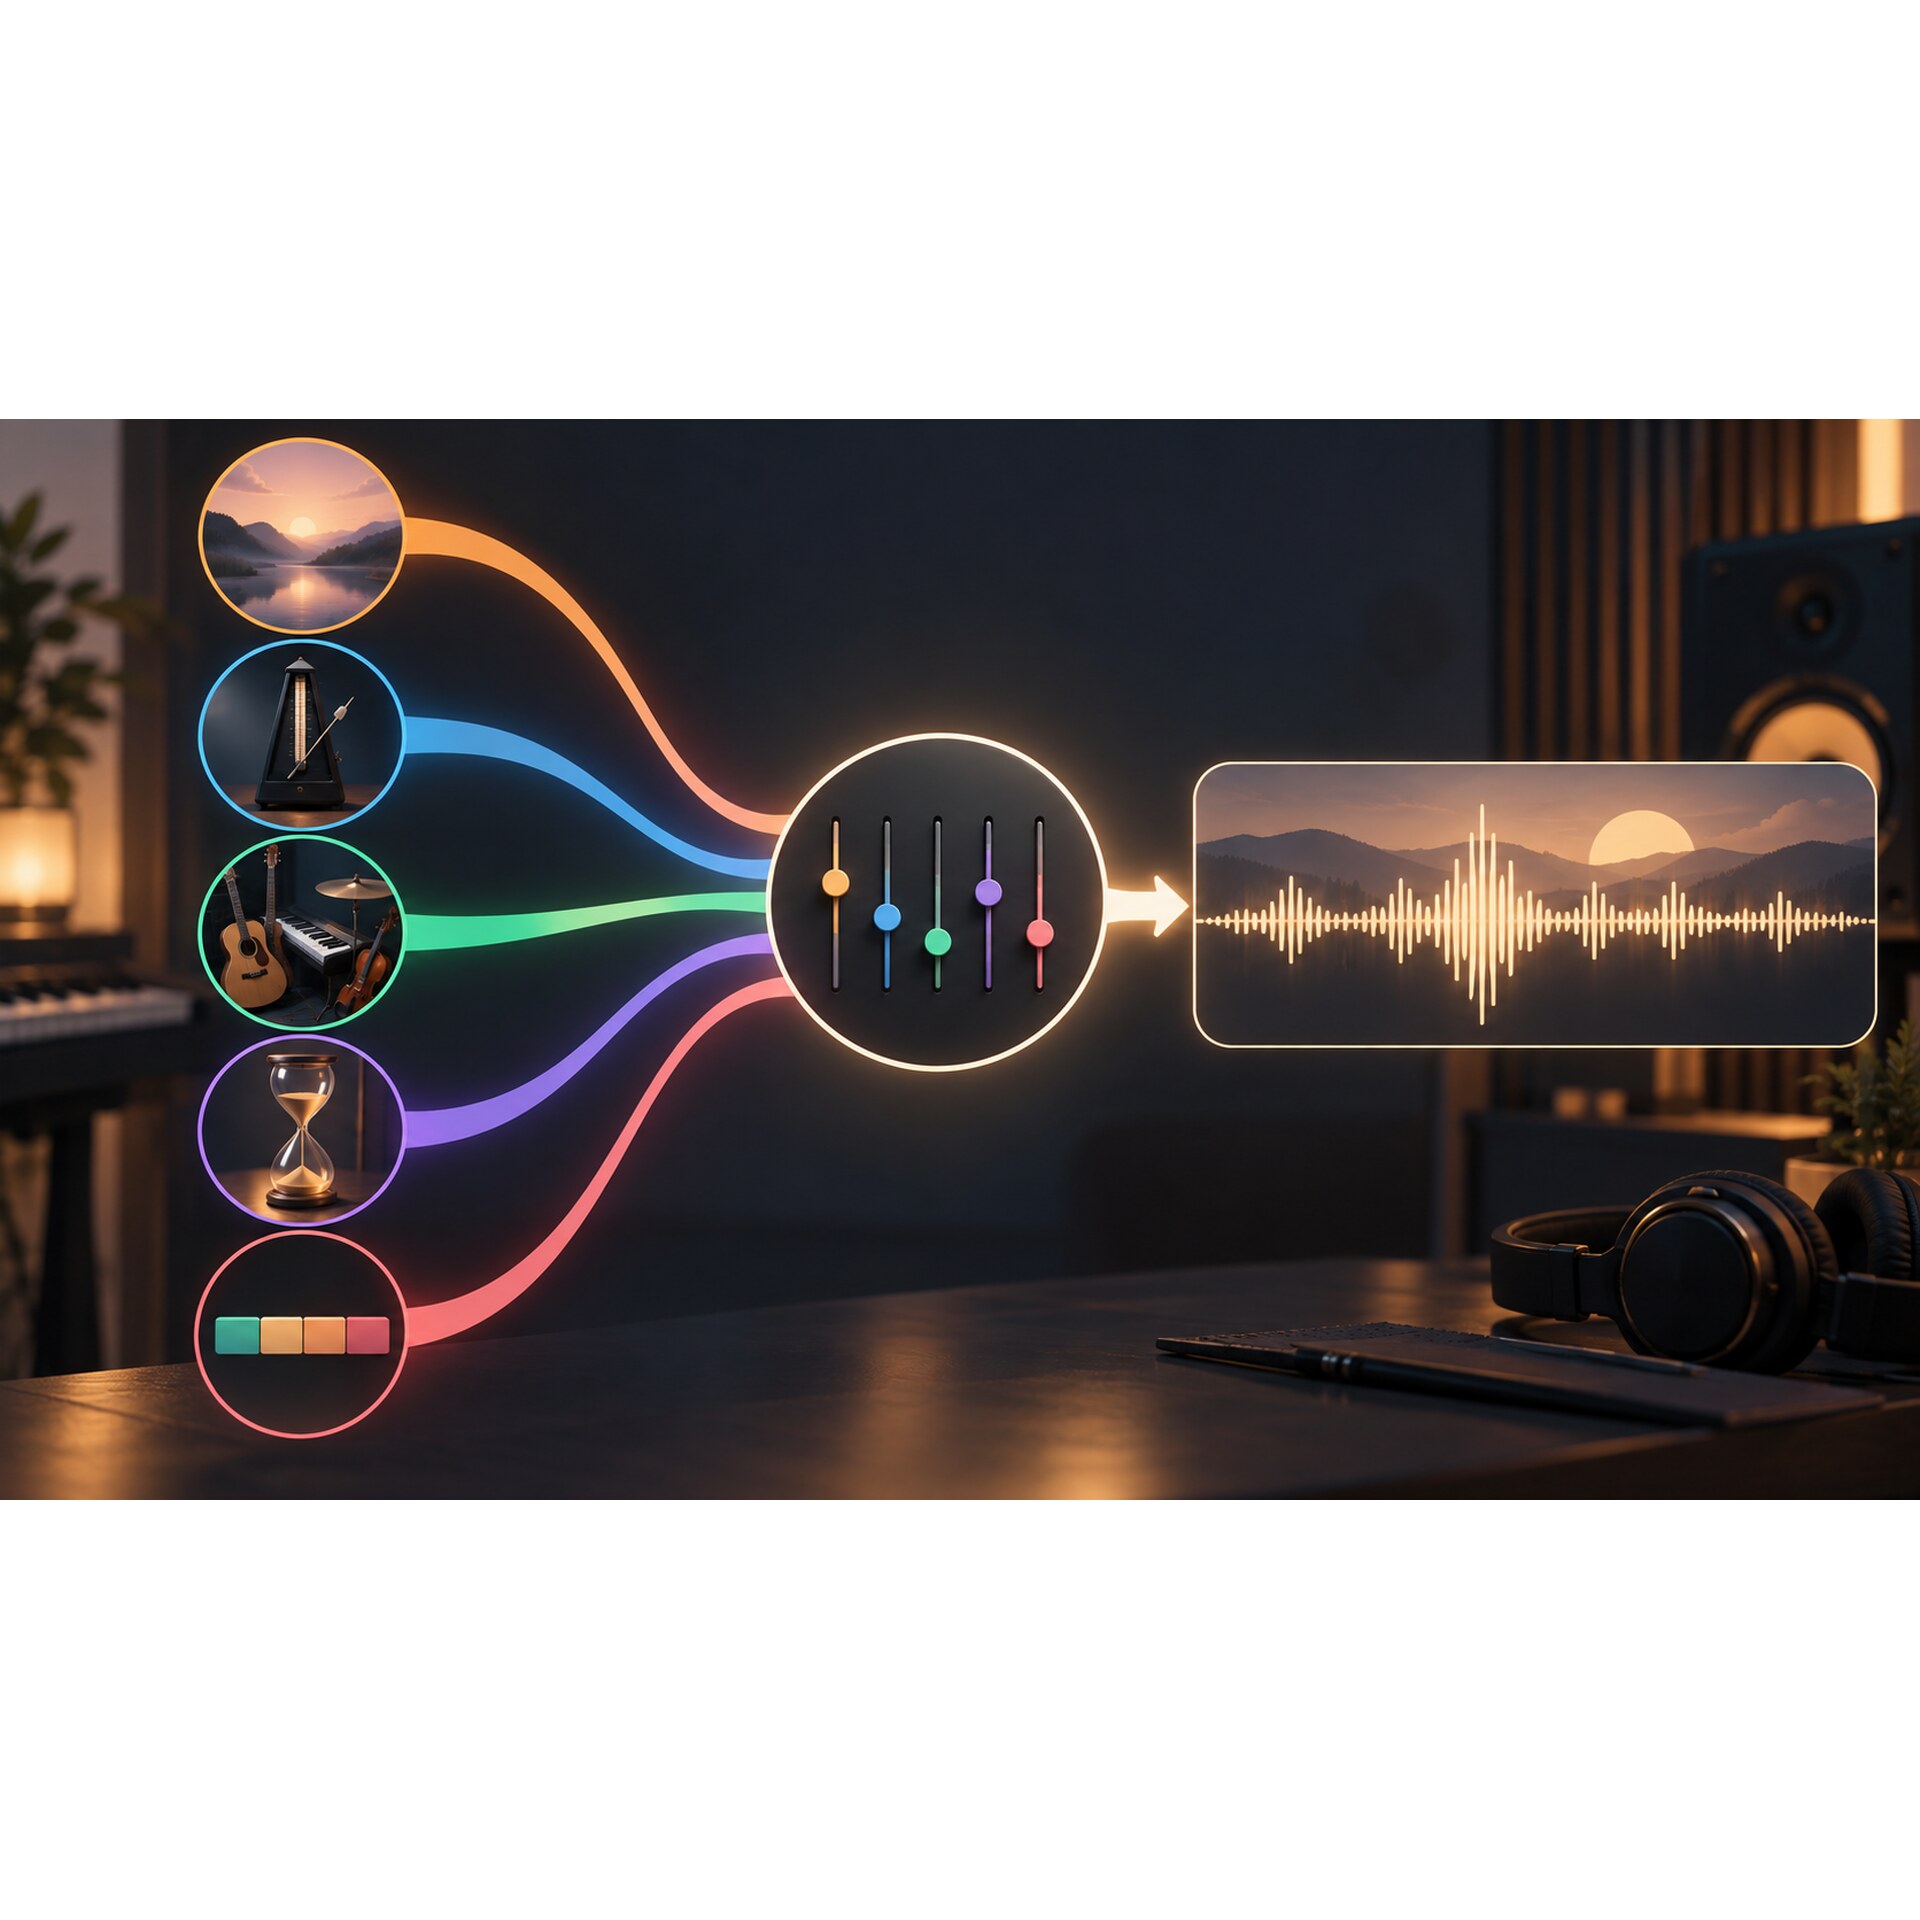
Запрос под фон отличается от запроса под самостоятельный трек тем, что в нём больше запретов, чем пожеланий. Собирается он из шести частей.
Назначение. Первым делом стоит написать, что это подложка под закадровый голос: многие генераторы учитывают такое указание и делают аранжировку разреженнее.
Настроение. Два-три слова: спокойное и деловое, тёплое, тревожное, торжественное. Абстракции вроде «красиво» и «современно» результат не двигают.
Темп. Задаётся словами или числом ударов в минуту. Ориентир — темп речи диктора: под размеренную начитку спокойный, под энергичный рекламный текст быстрый, но без дробного ритма.
Инструменты. Здесь решается судьба разборчивости. В запросе полезно называть и то, чего быть не должно.
Длительность и структура. Не «трек», а «отрезок такой-то длины с началом, ровной серединой и завершением».
Явные запреты. Без вокала, без резких сбивок, без нарастания к середине, без соло-инструмента в среднем регистре.
Форма запроса у сервисов разная, но практика переносится: она опирается на устройство задачи, а не на интерфейс. Сама генерация музыки собрана в разделе генератора фоновых треков по описанию.
Настроение, темп и инструменты в запросе к генератору музыки
Настроение и темп задают рамку, инструменты — реальную совместимость с голосом.
Безопасная палитра для подложки под речь: тянущиеся синтезаторные слои, мягкое фортепиано в верхнем регистре, приглушённая гитара без атаки, лёгкая перкуссия, негромкий бас. Всё это звучит по краям диапазона и оставляет середину свободной.
Опасная палитра: духовые, струнные в среднем регистре, аккордеон, солирующая скрипка, плотные пэды, любой инструмент с выраженной мелодией. Они занимают ровно ту зону, где живёт человеческий голос. Сюда же дробная перкуссия с частыми хай-хэтами: она маскирует согласные, по которым слушатель различает слова.
Полезная привычка: просить три-четыре варианта по одному описанию и выбирать не самый эффектный, а самый неприметный.
Вокал в фоне: почему он почти всегда спорит с закадровым голосом
Соблазн понятен: с вокалом трек звучит богаче. Под озвучку он не годится почти никогда, и причина не в громкости.
Мозг обрабатывает речь отдельным механизмом. Услышав разборчивое слово, он начинает его декодировать независимо от того, нужно это слушателю или нет. Два потока слов в одной дорожке заставляют переключаться между ними, и внимание рвётся даже тогда, когда вокал заметно тише диктора.
Второе: вокал занимает те же средние частоты, что и закадровый голос, с той же динамикой фраз и пауз. Обработкой их полностью не развести — они конкурируют по природе.
Третье: вокал не режется свободно. Инструментал режут в любом месте, а строчку — только по фразе, и монтаж подстраивается под музыку.
Вывод. Песня уместна там, где она сама и есть контент: джингл, вокальный ролик, заставка без текста поверх. Собрать такое можно в разделе создания песни с вокалом по тексту. Если понравившийся трек уже готов и вокал в нём лишний, есть обходной путь — снятие вокальной партии с готовой записи, но результат стоит переслушать: инструментал после разделения звучит иначе.
Длительность и структура: почему петля без конца не годится для ролика
Генераторы охотно выдают закольцованный материал: восемь тактов, которые повторяются, пока не надоест. Для стрима нормально, для ролика — источник проблем.
Петлю обрывают там, где кончилась речь, и слушатель слышит музыкальную фразу, оборванную на середине: это читается как техническая ошибка даже неподготовленным ухом. Второе — монотонность: одинаковые восемь тактов на протяжении двух минут перестают держать внимание и начинают усыплять.
Что просить вместо этого: отрезок с внятным началом, ровной серединой и завершением. В запросе это формулируется прямо — вступление на несколько секунд, ровная часть под речь, финальное затухание.
Длительность заказывается с запасом к хронометражу озвучки: лишнее подрезается по монтажу, а тянуть короткий трек нечем. Запас нужен и в конце — на хвост после последней фразы.
Как трек из нейросети уживается с голосом диктора
Это тот блок, ради которого статья и написана и который в материалах о генерации музыки обычно пропущен.
Голос и музыка делят одно физическое пространство — полосу частот и шкалу громкости. Разборчивость речи держится в основном на согласных, а они живут в средней и верхней середине диапазона, примерно от одного до четырёх килогерц. Гласные и объём голоса — ниже. Если в этой же зоне играет мелодический инструмент, слова остаются слышны, но перестают быть разборчивыми: слушатель понимает сказанное только по контексту.
Отсюда правило про плотность. Чем больше инструментов звучит одновременно, тем меньше в аранжировке свободного места. Плотный микс не оставляет речи промежутка, куда она может встать, и голос приходится вытягивать громкостью — а это делает его резким и утомительным.
Логика обратная привычной: место освобождает музыка, а не занимает голос. Середина в аранжировке под речь должна быть разрежена изначально, а не расчищена потом обработкой.
Частоты и плотность: почему аранжировка съедает разборчивость речи
Проверить конфликт можно без анализатора, на слух, и есть три бытовых теста.
Тест на телефоне. Микс слушается через динамик смартфона на средней громкости. Маленький динамик почти не воспроизводит низ, зато подчёркивает середину — ровно ту, где идёт спор. Разбираются слова там — на нормальной акустике будет лучше.
Тест на отвлечение. Ролик включается фоном, пока делается что-то ещё. Так слушают в реальности. Если при отвлечённом внимании смысл теряется, фон громкий или слишком активный.
Тест по расшифровке. Незнакомому человеку даётся микс и просьба записать номер, адрес или термин из текста. Ошибся — проблема не в его слухе.
Когда конфликт обнаружен, первый шаг — не ручка громкости, а материал: убрать из фона спорящий инструмент, взять более разреженный вариант, снизить темп. Второй — эквалайзер: в фоне убирается та самая средняя полоса. Третий — приглушение под фразами.
Автоматическое приглушение музыки под голос: что это и зачем
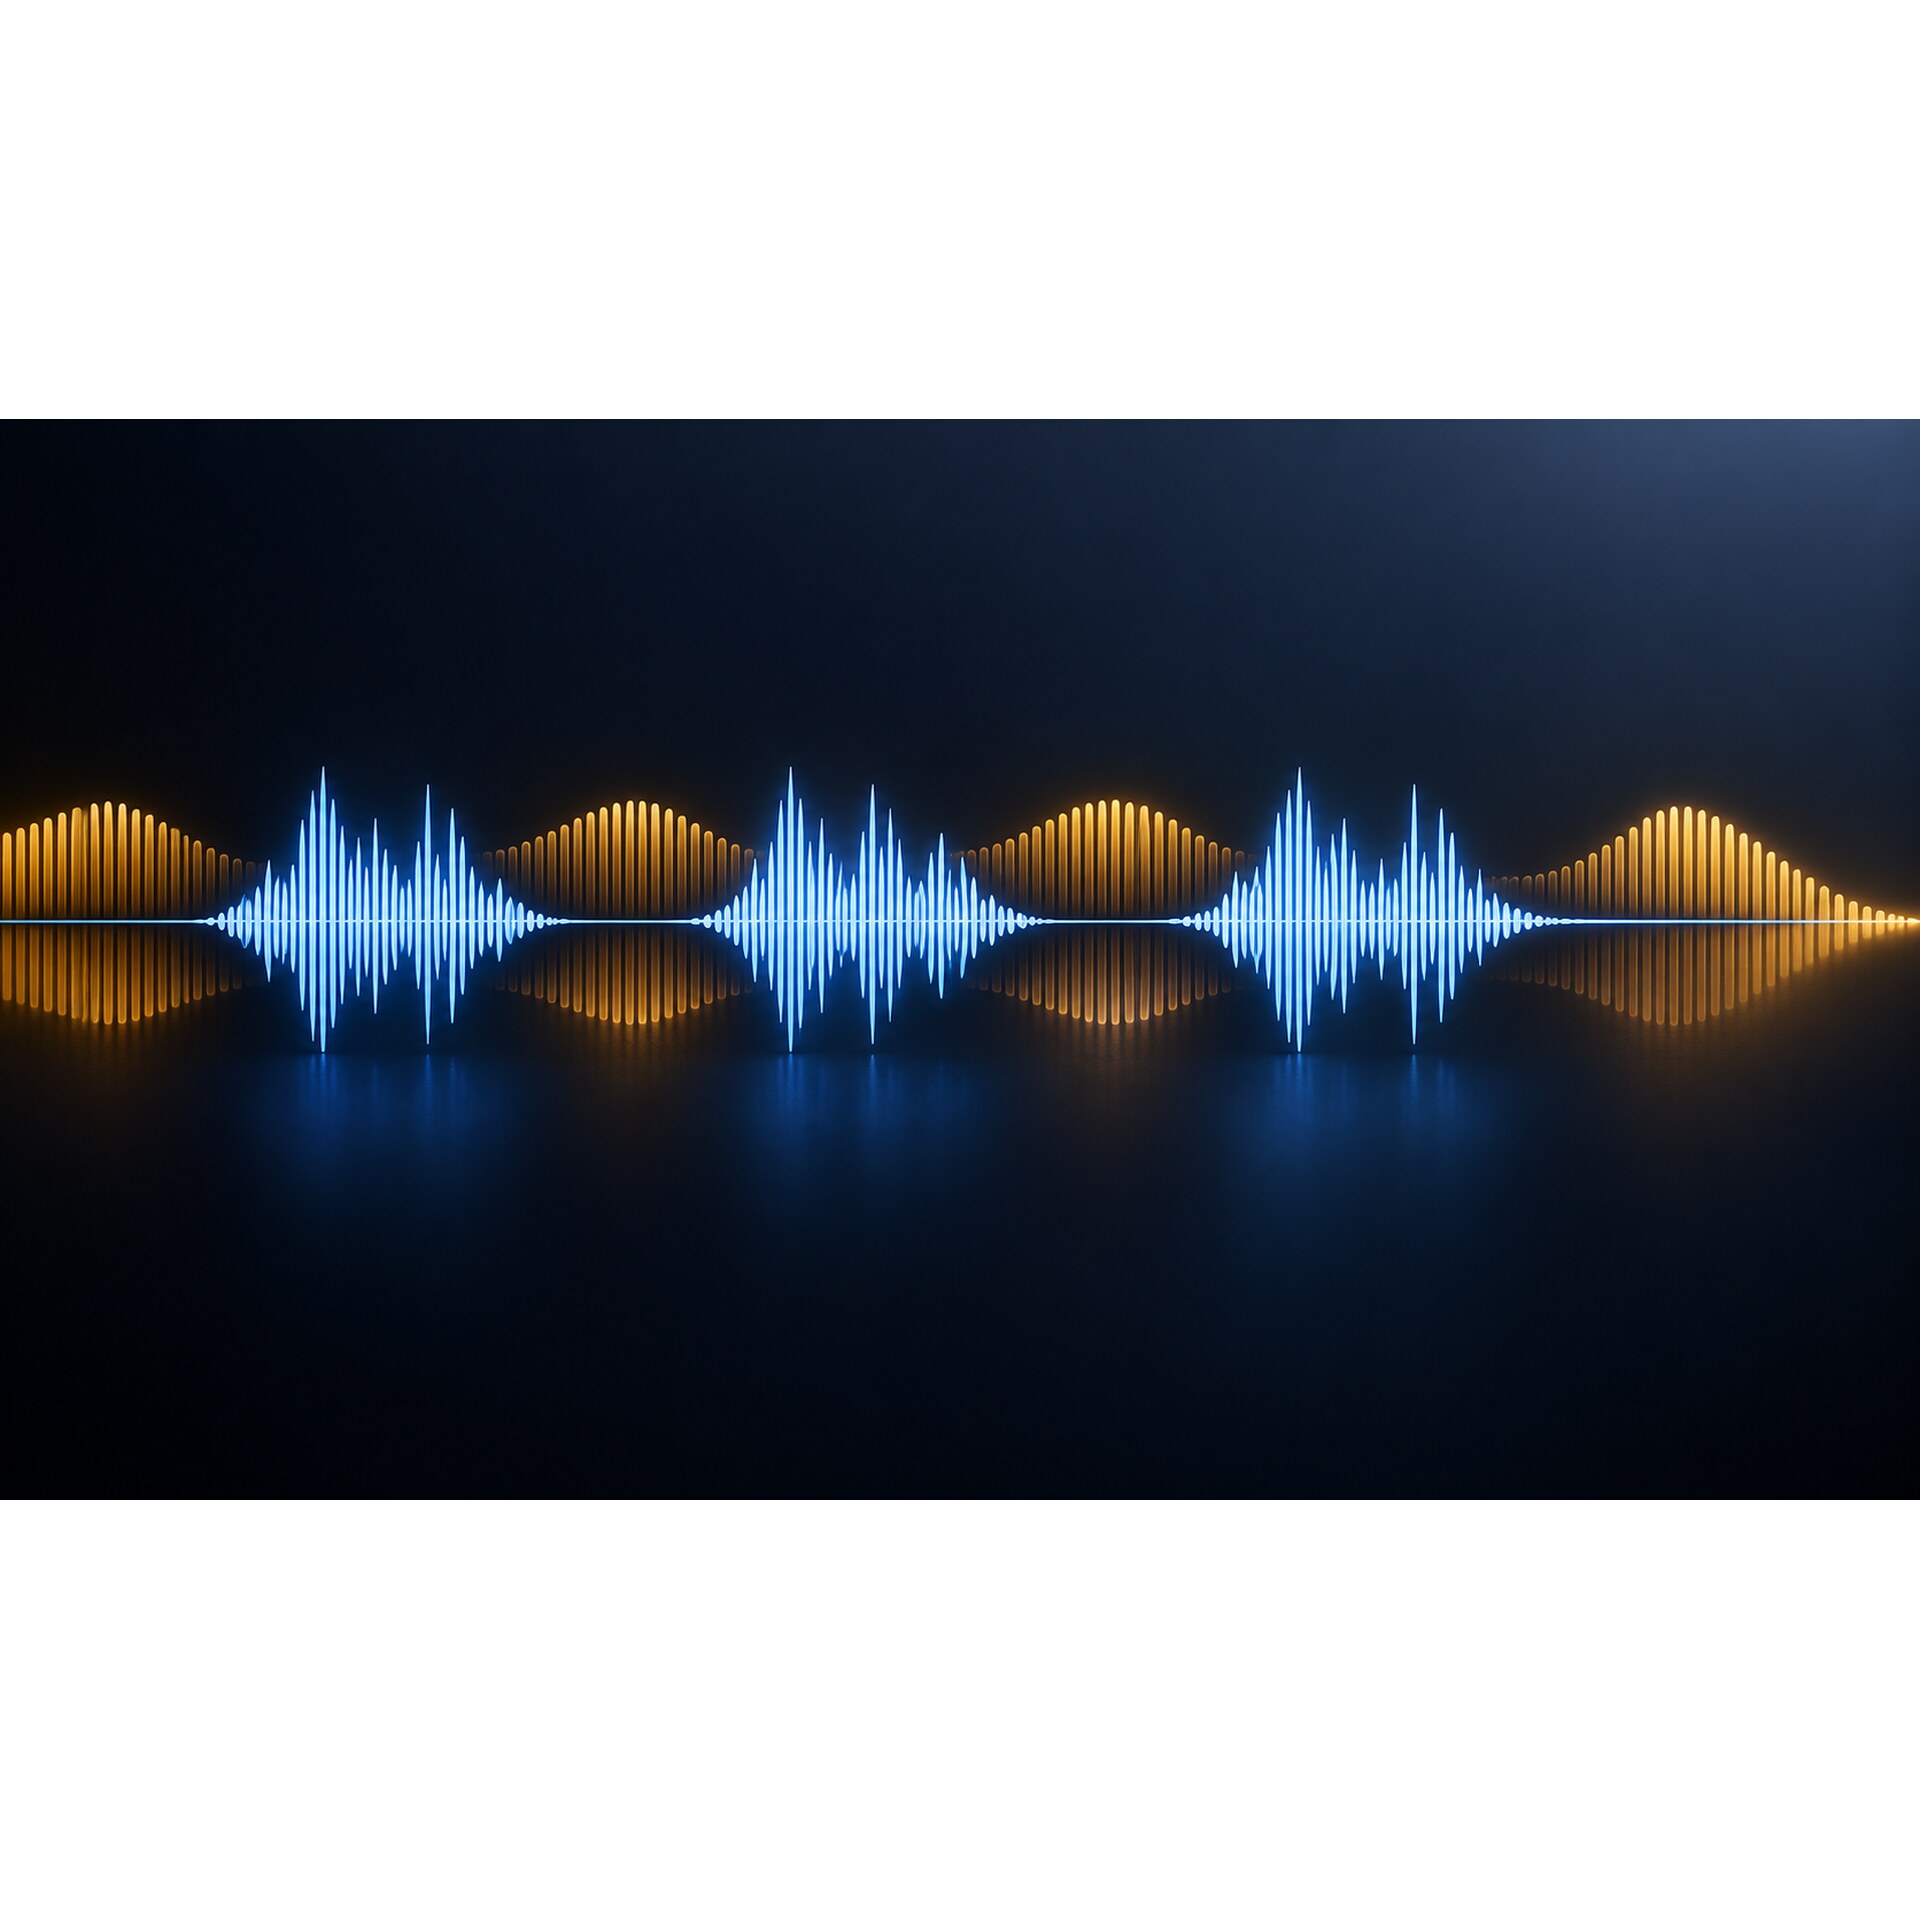
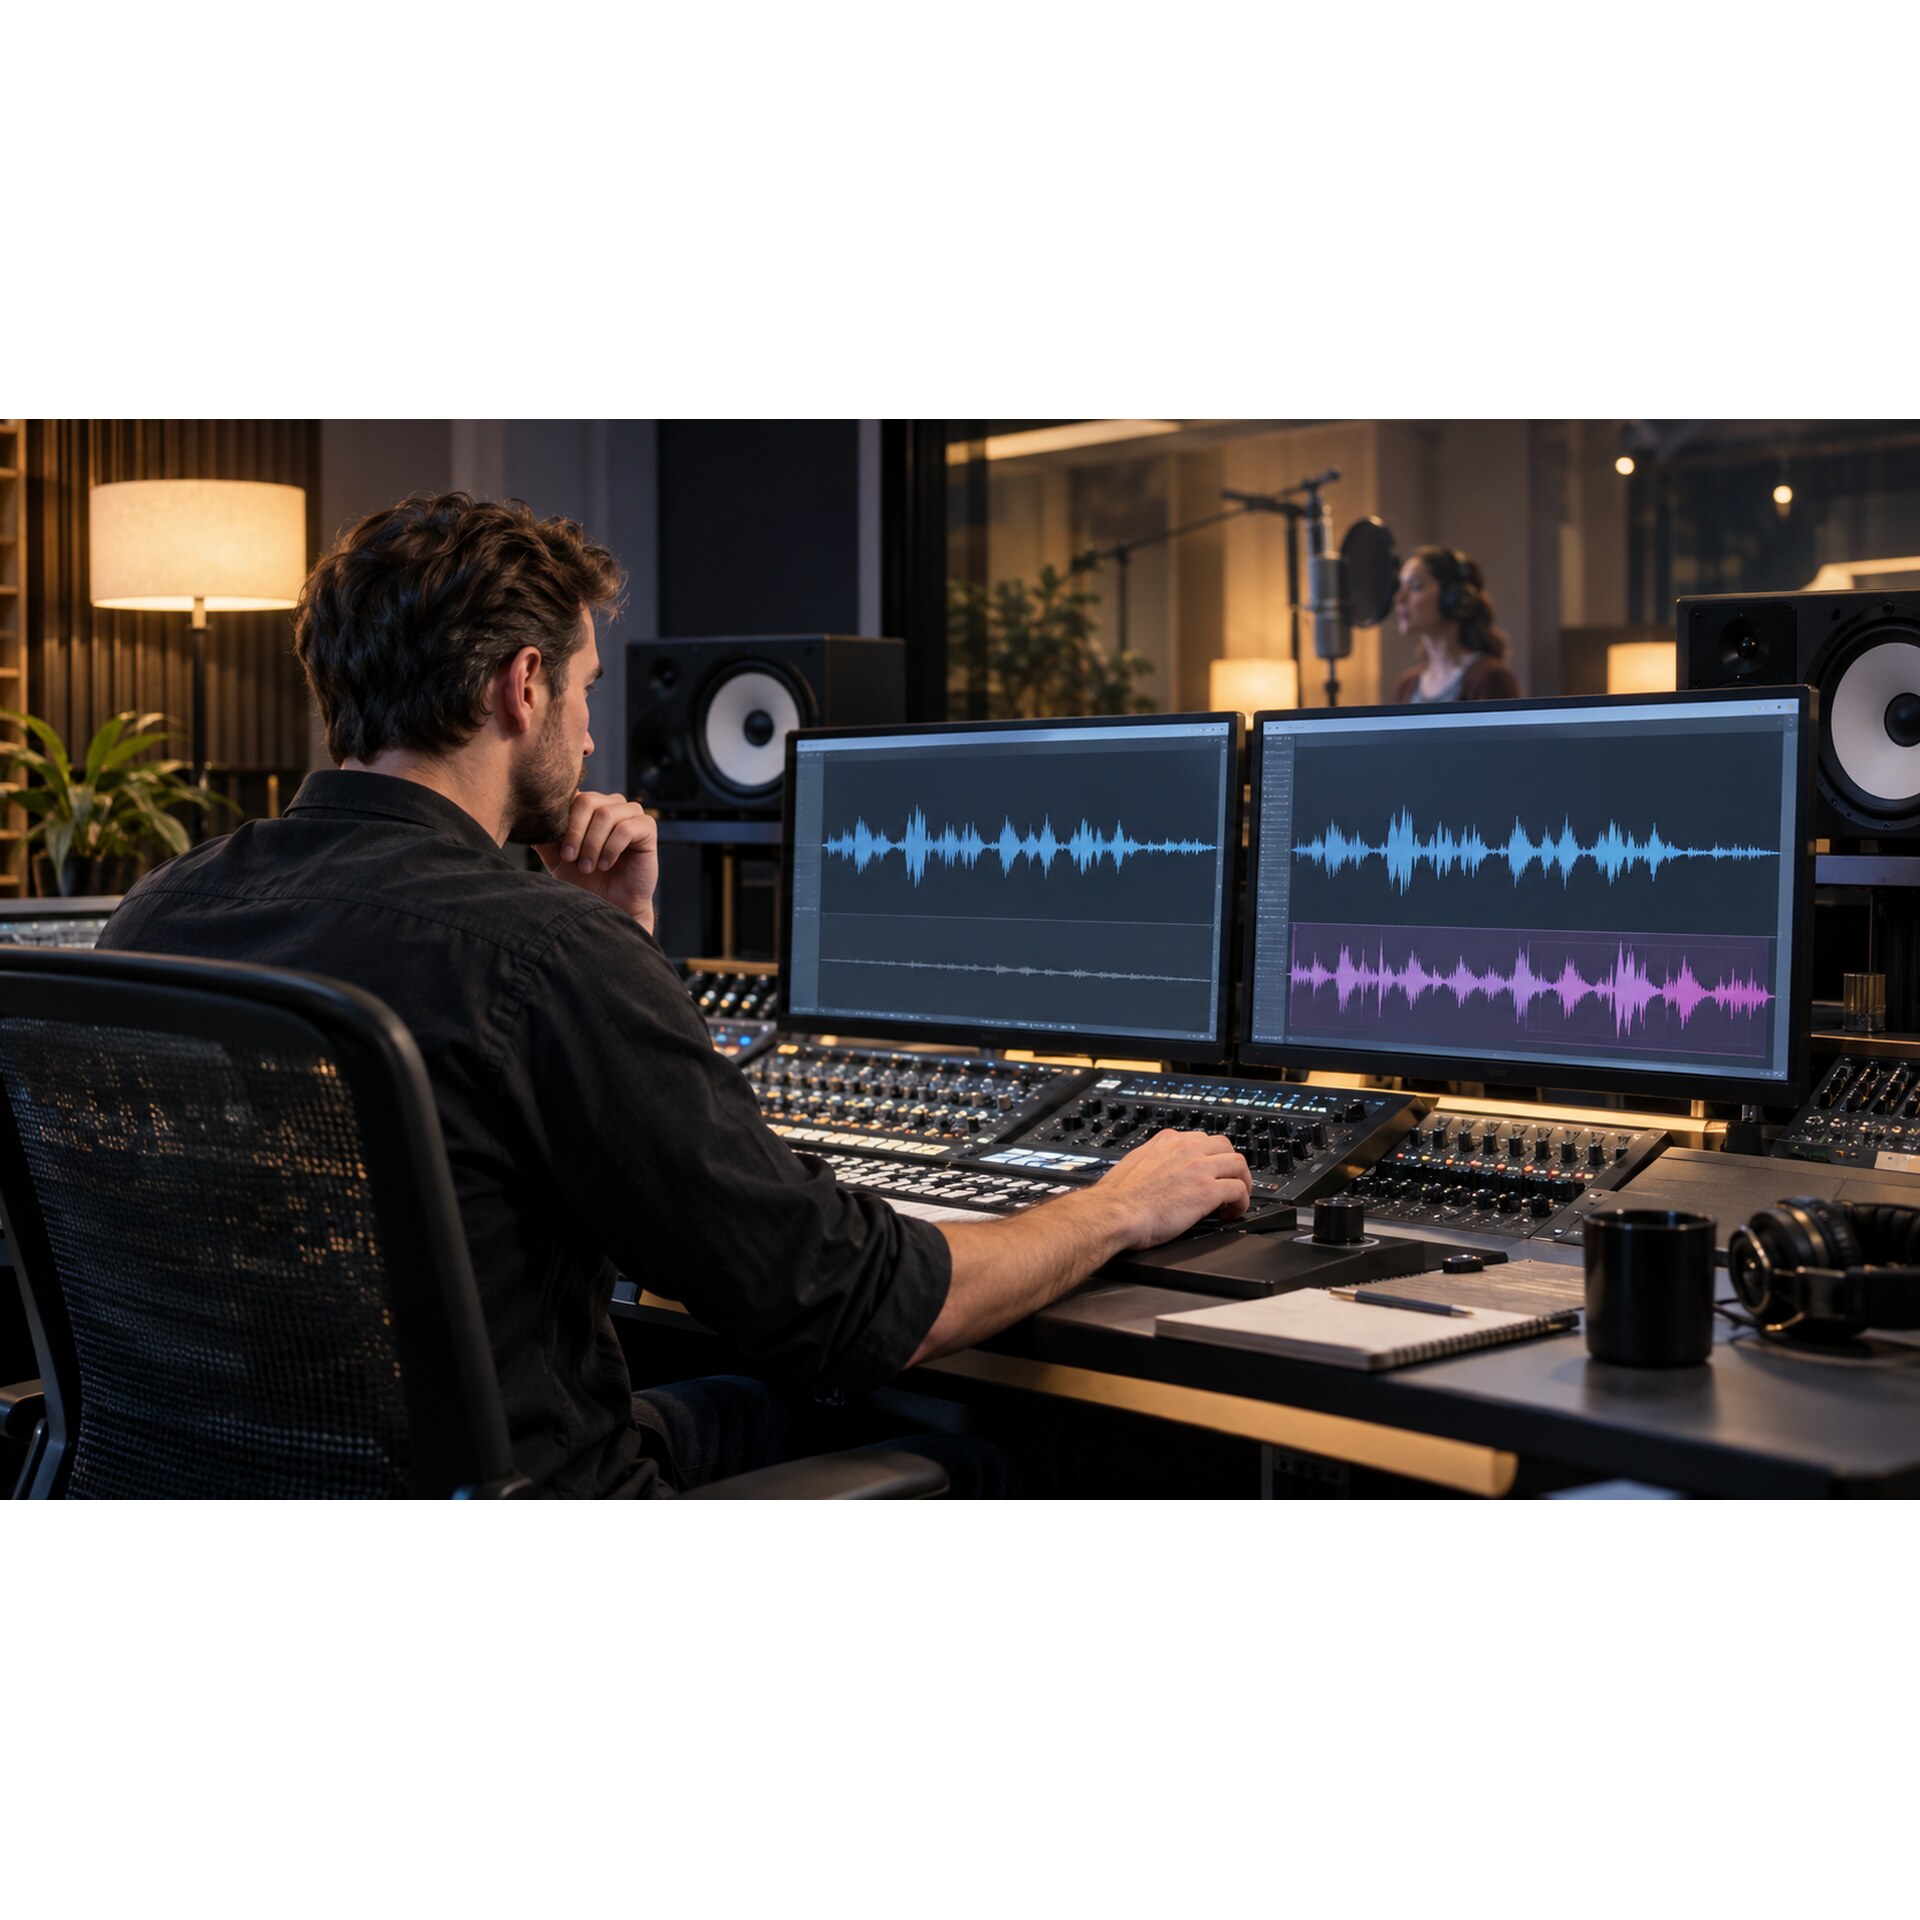
Приём, который отличает собранный ролик от склеенного: фон становится тише, как только звучит речь, и возвращается к прежнему уровню в паузах. В монтажных программах это компрессор с внешним источником управления или отдельная функция с названием вроде «дакинг».
Механизм такой: анализируется дорожка голоса и по ней управляется громкость музыки. Есть фраза — фон опускается, кончилась — поднимается обратно.
Почему без этого фон наезжает на диктора. Живая речь неровная: одни фразы сильнее, другие тише, между ними паузы. Статичный фон, выставленный по громкой фразе, накроет тихую; выставленный по тихой — провалится в паузах, и ролик задышит рывками. Один уровень на весь ролик не подходит к речи в принципе.
Два параметра стоит настроить осмысленно. Глубина приглушения: слишком маленькая ничего не даст, слишком большая превратит фон в мигающий. И скорость возврата: если фон подскакивает сразу после слова, между фразами появляются толчки, поэтому возврат делают плавным.
Порядок работы: сначала голос, потом подбор музыки
Самая частая и самая дорогая ошибка — обратный порядок: автор находит трек, влюбляется в него и укладывает речь в чужой ритм.
Что при этом ломается. Диктору приходится подгонять темп, отчего начитка теряет естественность. Паузы расставляются по музыкальным долям, а не по смыслу. Хронометраж определяется длиной трека, а не текстом сценария. Финал подчиняется музыкальной точке, хотя должен подчиняться последней фразе.
Правильная последовательность занимает столько же времени, но экономит переделки:
- пишется и вычитывается текст;
- записывается или синтезируется голос;
- измеряется реальный хронометраж дорожки с паузами;
- под этот хронометраж, темп и настроение подбирается фон;
- фон подрезается по монтажу и приглушается под фразами;
- микс проверяется тестами из предыдущего раздела.
Деталь для тех, кто озвучивает синтезом: дорожку удобнее забирать в WAV, если впереди сведение голоса с музыкой, и в MP3, если она идёт в публикацию как есть. Ориентир по студийным заказам: ролики отдаются в mp3 320 kbps stereo, начитка — в wav 44 100 Гц, 16 бит, моно. По деньгам разовая озвучка в сервисе указана как 0 ₽, с тарифом — 20 ₽; состав пакетов и лимиты уточняются в интерфейсе. Данные сверены 10 сентября 2026 года.
Уровни: как на слух соотносить громкость музыки и речи
Точную цифру для всех роликов назвать нельзя: она зависит от плотности трека, манеры диктора и площадки. Зато есть ориентиры, работающие без приборов.
Базовый. Под речью фон должен ощущаться, а не прослушиваться. Признак нормы: присутствие музыки замечается, но мелодия по памяти не восстанавливается.
Проверка на паузе. В паузах между фразами фон поднимается и слышен отчётливо. Если он не слышен и там, он просто не нужен.
Порядок настройки: сначала голос выводится на комфортный уровень, потом фон поднимается снизу до момента, когда начинает мешать, и опускается на шаг назад. Не наоборот: подгонять голос под выставленную музыку — верный способ получить крикливую начитку.
Тайминг: вступление, уход и хвост музыки в ролике
Уровни отвечают за одновременное звучание, тайминг — за границы. Ошибки на границах слышны сильнее всего.
Вступление. Музыка начинается раньше речи — от секунды до нескольких, по формату. Ролик, где фон и первое слово стартуют вместе, звучит как случайно включённая запись.
Вход под речь. Фон не должен появляться вместе с началом фразы: это привлекает внимание к самому появлению. Музыка вводится в паузу и нарастает за неё.
Уход. Тот же принцип наоборот: фон уходит не на слове, а в паузе, и не мгновенно, а затуханием. Резкий обрыв допустим только как приём, совпадающий с монтажной склейкой.
Хвост. После последней фразы музыке дают договорить — от одной до нескольких секунд. Ролик, оборванный сразу после точки, ощущается недоделанным, а хвост даёт паузу на осмысление.
Права на музыку из нейросети: что проверяется до публикации
Блок, который в статьях про генераторы обычно сводится к фразе «всё можно». Это не так.
Условия у сервисов разные. Право на коммерческое использование сгенерированного трека, необходимость указания источника, ограничения по тарифу — всё это устанавливает конкретный сервис, и различия существенные. Общего правила нет, условия сверяются на странице сервиса до того, как трек попадёт в проект. Разборы отдельных моделей есть на сайте: например, страница модели Suno на платформе.
Генерация не снимает вопрос прав. Сам факт, что трек создан машиной, не отвечает на вопрос, что с ним разрешено делать. Статус определяется условиями сервиса и законодательством, а не способом получения файла.
Чужой исходник тянет за собой права на исходник. Если в проект загружался фрагмент чужой записи, семпл, мелодия или голос, требуется право на этот материал. Обработка нейросетью его не обнуляет.
Параллель с озвучкой прямая, и формулировка одна для обоих случаев: использовать готовое аудио в коммерческом проекте можно только тогда, когда это разрешено условиями модели и тарифа, а для чужих голосов и загруженных образцов дополнительно нужно право на исходную запись. Музыка и речь тут не отличаются: и то и другое — материал с правообладателем.
Для роликов, которые идут в эфир или в публичную трансляцию, у студии предусмотрен паспорт ролика — документ, подтверждающий правомерность воспроизведения того, что в ролике звучит. Запрашивается он при заказе и оформляется заранее. Условия сверены 10 сентября 2026 года.
Сводная таблица: формат, необходимость музыки, тип фона и ошибка
| Формат контента | Нужна ли музыка | Какой фон подходит | Типичная ошибка |
|---|---|---|---|
| Рекламный аудиоролик | Обязательна | Динамичная подложка с началом и точкой в конце, без вокала под текстом | Трек громче диктора, номер и адрес не разбираются |
| Видеореклама | Обязательна | Ритмичная, синхронная с монтажом, разреженная в середине | Музыка выбрана до записи голоса, речь подгоняется под ритм |
| Обучающий модуль | Частично | Тихая нейтральная подложка на заставке и переходах | Фон под определениями и перечислениями |
| Подкаст и интервью | Только в шапке | Короткая тема на вступление и отбивки | Постоянный фон под живым диалогом |
| Видео на канале | По монтажу | Спокойный фон под нарезкой, тишина под объяснением | Один трек петлёй на весь выпуск |
| Аудиогид | Чаще не нужна | Максимум — короткая тема на входе в раздел маршрута | Подложка поверх уличного шума, названия теряются |
| Презентация с озвучкой | По задаче | Едва слышная подложка без развития | Мелодия отвлекает от цифр на слайде |
| Голосовое меню | Не нужна | Чистая речь, при необходимости сигнал-разделитель | Мелодия под перечислением пунктов меню |
Чек-лист сдачи ролика: разборчивость, уровни, стыки и права
Девять пунктов перед отправкой заказчику или публикацией. Порядок идёт от главного к техническому.
- Разборчивость. Ключевые слова — название, номер, адрес, термин — разбираются с первого раза при отвлечённом внимании и на динамике телефона.
- Уровни. Фон ощущается, но не прослушивается; в паузах слышен отчётливо, под речью с ней не спорит.
- Отсутствие вокала под текстом. Никаких слов в фоне там, где говорит диктор.
- Приглушение. Фон опускается под фразами и возвращается в паузах плавно, без толчков.
- Начало. Музыка стартует раньше первой фразы, вход сделан в паузу, а не на слове.
- Стыки. Смены фона и склейки не приходятся на середину фразы; петля не обрывается посреди музыкальной фразы.
- Хвост. После последней фразы музыка договаривает и затухает.
- Форматы. Файл соответствует площадке: MP3 для публикации, WAV для дальнейшего сведения. Ориентиры студии — mp3 320 kbps stereo для роликов и wav 44 100 Гц, 16 бит, моно для начитки.
- Права. Условия сервиса на коммерческое использование проверены, право на загруженные чужие материалы есть, для эфира оформлен паспорт ролика.
FAQ: нейросеть для создания музыки — вопросы о фоне под озвучку
Можно ли сделать фон под ролик без музыкального образования?
Да, если задача сформулирована как техническая. Описываются настроение, темп, инструменты, длительность и запреты — вокал, резкие сбивки, солирующий инструмент в среднем регистре. Дальше из нескольких вариантов выбирается самый неприметный.
Почему сгенерированный трек звучит хорошо отдельно и плохо в ролике?
Отдельно он оценивается как музыка, а в ролике работает как подложка. Богатая аранжировка занимает середину диапазона, где живёт разборчивость речи, и голос начинает конкурировать с фоном.
Как понять, что музыка мешает речи?
Три проверки: прослушать микс через динамик телефона, включить ролик фоном при отвлечённом внимании и попросить незнакомого человека записать на слух ключевое слово. Ошибка в третьем тесте означает конфликт.
Что делать, если фон нравится, но перекрывает голос?
Сначала менять материал: убрать спорящий инструмент, взять разреженный вариант, снизить темп. Потом убирать в фоне среднюю полосу эквалайзером. И только затем настраивать приглушение под фразами.
Нужен ли вокал в фоновой музыке для рекламы?
Под закадровым текстом — нет: два потока слов рвут внимание. Вокал уместен там, где он сам является содержанием: джингл, вокальный ролик, заставка без речи поверх.
Что такое автоматическое приглушение фона и обязательно ли оно?
Это уменьшение громкости музыки в моменты, когда звучит речь, и возврат к прежнему уровню в паузах. Обязательным его назвать нельзя, но без него статичный фон накрывает тихие фразы диктора.
Сколько секунд музыки оставлять после последней фразы?
От одной до нескольких, по темпу ролика. Смысл хвоста служебный: он даёт паузу на осмысление и закрывает ролик, вместо того чтобы обрывать его на точке.
Можно ли использовать сгенерированный трек в коммерческом ролике?
Только если это разрешено условиями конкретного сервиса и тарифа: правила у разных генераторов различаются и сверяются на их страницах. Если в проект загружались чужие записи или образцы, дополнительно нужно право на исходный материал.
В каком формате забирать дорожку голоса, если её ещё сводить с фоном?
В WAV: сжатие теряет часть данных, и после нескольких пересохранений это слышно на согласных. MP3 берётся тогда, когда дорожка идёт в публикацию без дальнейшей обработки.
Что делать, если генератор выдаёт только зацикленный отрывок?
Собирать структуру вручную: середина повторяется нужное число раз, а вступление и завершение берутся из отдельных генераций. Обрывать петлю посреди музыкальной фразы нельзя.
Итог: нейросеть для создания музыки должна работать на речь
Фон в ролике служебный. Он склеивает монтаж, задаёт темп и закрывает паузы, но не претендует на внимание: как только у музыки появляется собственный сюжет, речь уходит на второй план. Хороший фон под озвучку скучен при отдельном прослушивании.
Отсюда практика. В запросе указываются назначение, настроение, темп, безопасные инструменты, длительность со структурой и явные запреты, первый из которых — отсутствие вокала: два потока слов конкурируют независимо от разницы в громкости. Середина частотного диапазона оставляется свободной под согласные, аранжировка берётся разреженная, динамика ровная. Порядок всегда один: текст, голос, хронометраж — и только потом музыка для ролика подбирается под готовую дорожку.
Уровни выставляются от голоса вниз, фон приглушается под фразами и возвращается в паузах плавно. Границы важнее середины: музыка входит и уходит в паузах, а не на словах, и оставляет хвост после последней фразы. Проверка делается тремя тестами на слух, без приборов.
Права проверяются до публикации. Условия коммерческого использования у сервисов разные и сверяются на их страницах; сгенерированный файл сам по себе вопрос принадлежности не закрывает; на чужие записи и образцы нужно право на исходник. С озвучкой правило то же: коммерческое использование готового аудио возможно, только если это разрешено условиями модели и тарифа. Для эфирных роликов у студии оформляется паспорт ролика. Цифры и условия сверены 10 сентября 2026 года.
Дальше остаётся проверить связку на своём материале: озвучить сценарий и послушать голос до подбора фона — тогда музыка подбирается под речь, а не речь подгоняется под музыку.
Читайте также: что происходит с фоном и речью на этапе сведения и как привести голос в форму перед записью смены.