




Запрос «Лучшие ИИ для озвучки текста» обычно приводит на страницу с нумерованным списком, где первую строчку занимает сервис, который не оплатить российской картой, а вторую — движок, ставящий ударения в русских словах наугад. Список без методики не помогает выбрать: он ранжирует названия, а не пригодность под задачу. Поэтому сначала — параметры, по которым сервисы имеет смысл сравнивать, и только потом обзор моделей. Проверить гипотезу проще всего на коротком фрагменте: нейросетевая озвучка в браузере запускается без установки программ.
Методика важнее рейтинга ещё и потому, что «лучший» зависит от сценария: для разового ролика решает один набор свойств, для еженедельных выпусков — другой, для курса на сорок модулей — третий. Цены и лимиты сторонних сервисов здесь не называются: они меняются чаще, чем выходят обзоры.
В статье:
- восемь параметров, по которым честно сравнивают сервис синтеза речи;
- почему «сколько голосов» — пустой показатель, а чтение чисел и сокращений — решающий;
- обзор восьми движков: ElevenLabs, Murf, Speechify, Fish Audio, Yandex SpeechKit, SaluteSpeech, MiniMax Audio и OpenAI Whisper;
- таблица «специализация — что проверить перед выбором»;
- четыре профиля задач и параметр, который решает в каждом;
- промахи: права, оплата, ударения, длина текста, поддержка.
Почему запрос «лучшие ИИ для озвучки текста» не закрывается готовым списком
Рейтинг сервисов озвучки собирается по критериям автора, а не читателя: количество языков, известность бренда, мобильное приложение. Ни один из них не отвечает на вопрос, прочитает ли движок фразу «в 2026 году компания вложила 6 990 ₽» так, чтобы её не пришлось перезаписывать.
Вторая причина — география. Значительная часть публичных подборок пишется без оглядки на то, доступна ли оплата из России, а сервис бывает отличным по звучанию и бесполезным в работе, если платёж не проходит.
Третья причина — задача. Подкаст, телефонное меню и обучающее видео предъявляют разные требования: где-то нужна живость интонации, где-то разборчивость, где-то единый голос на протяжении месяцев.
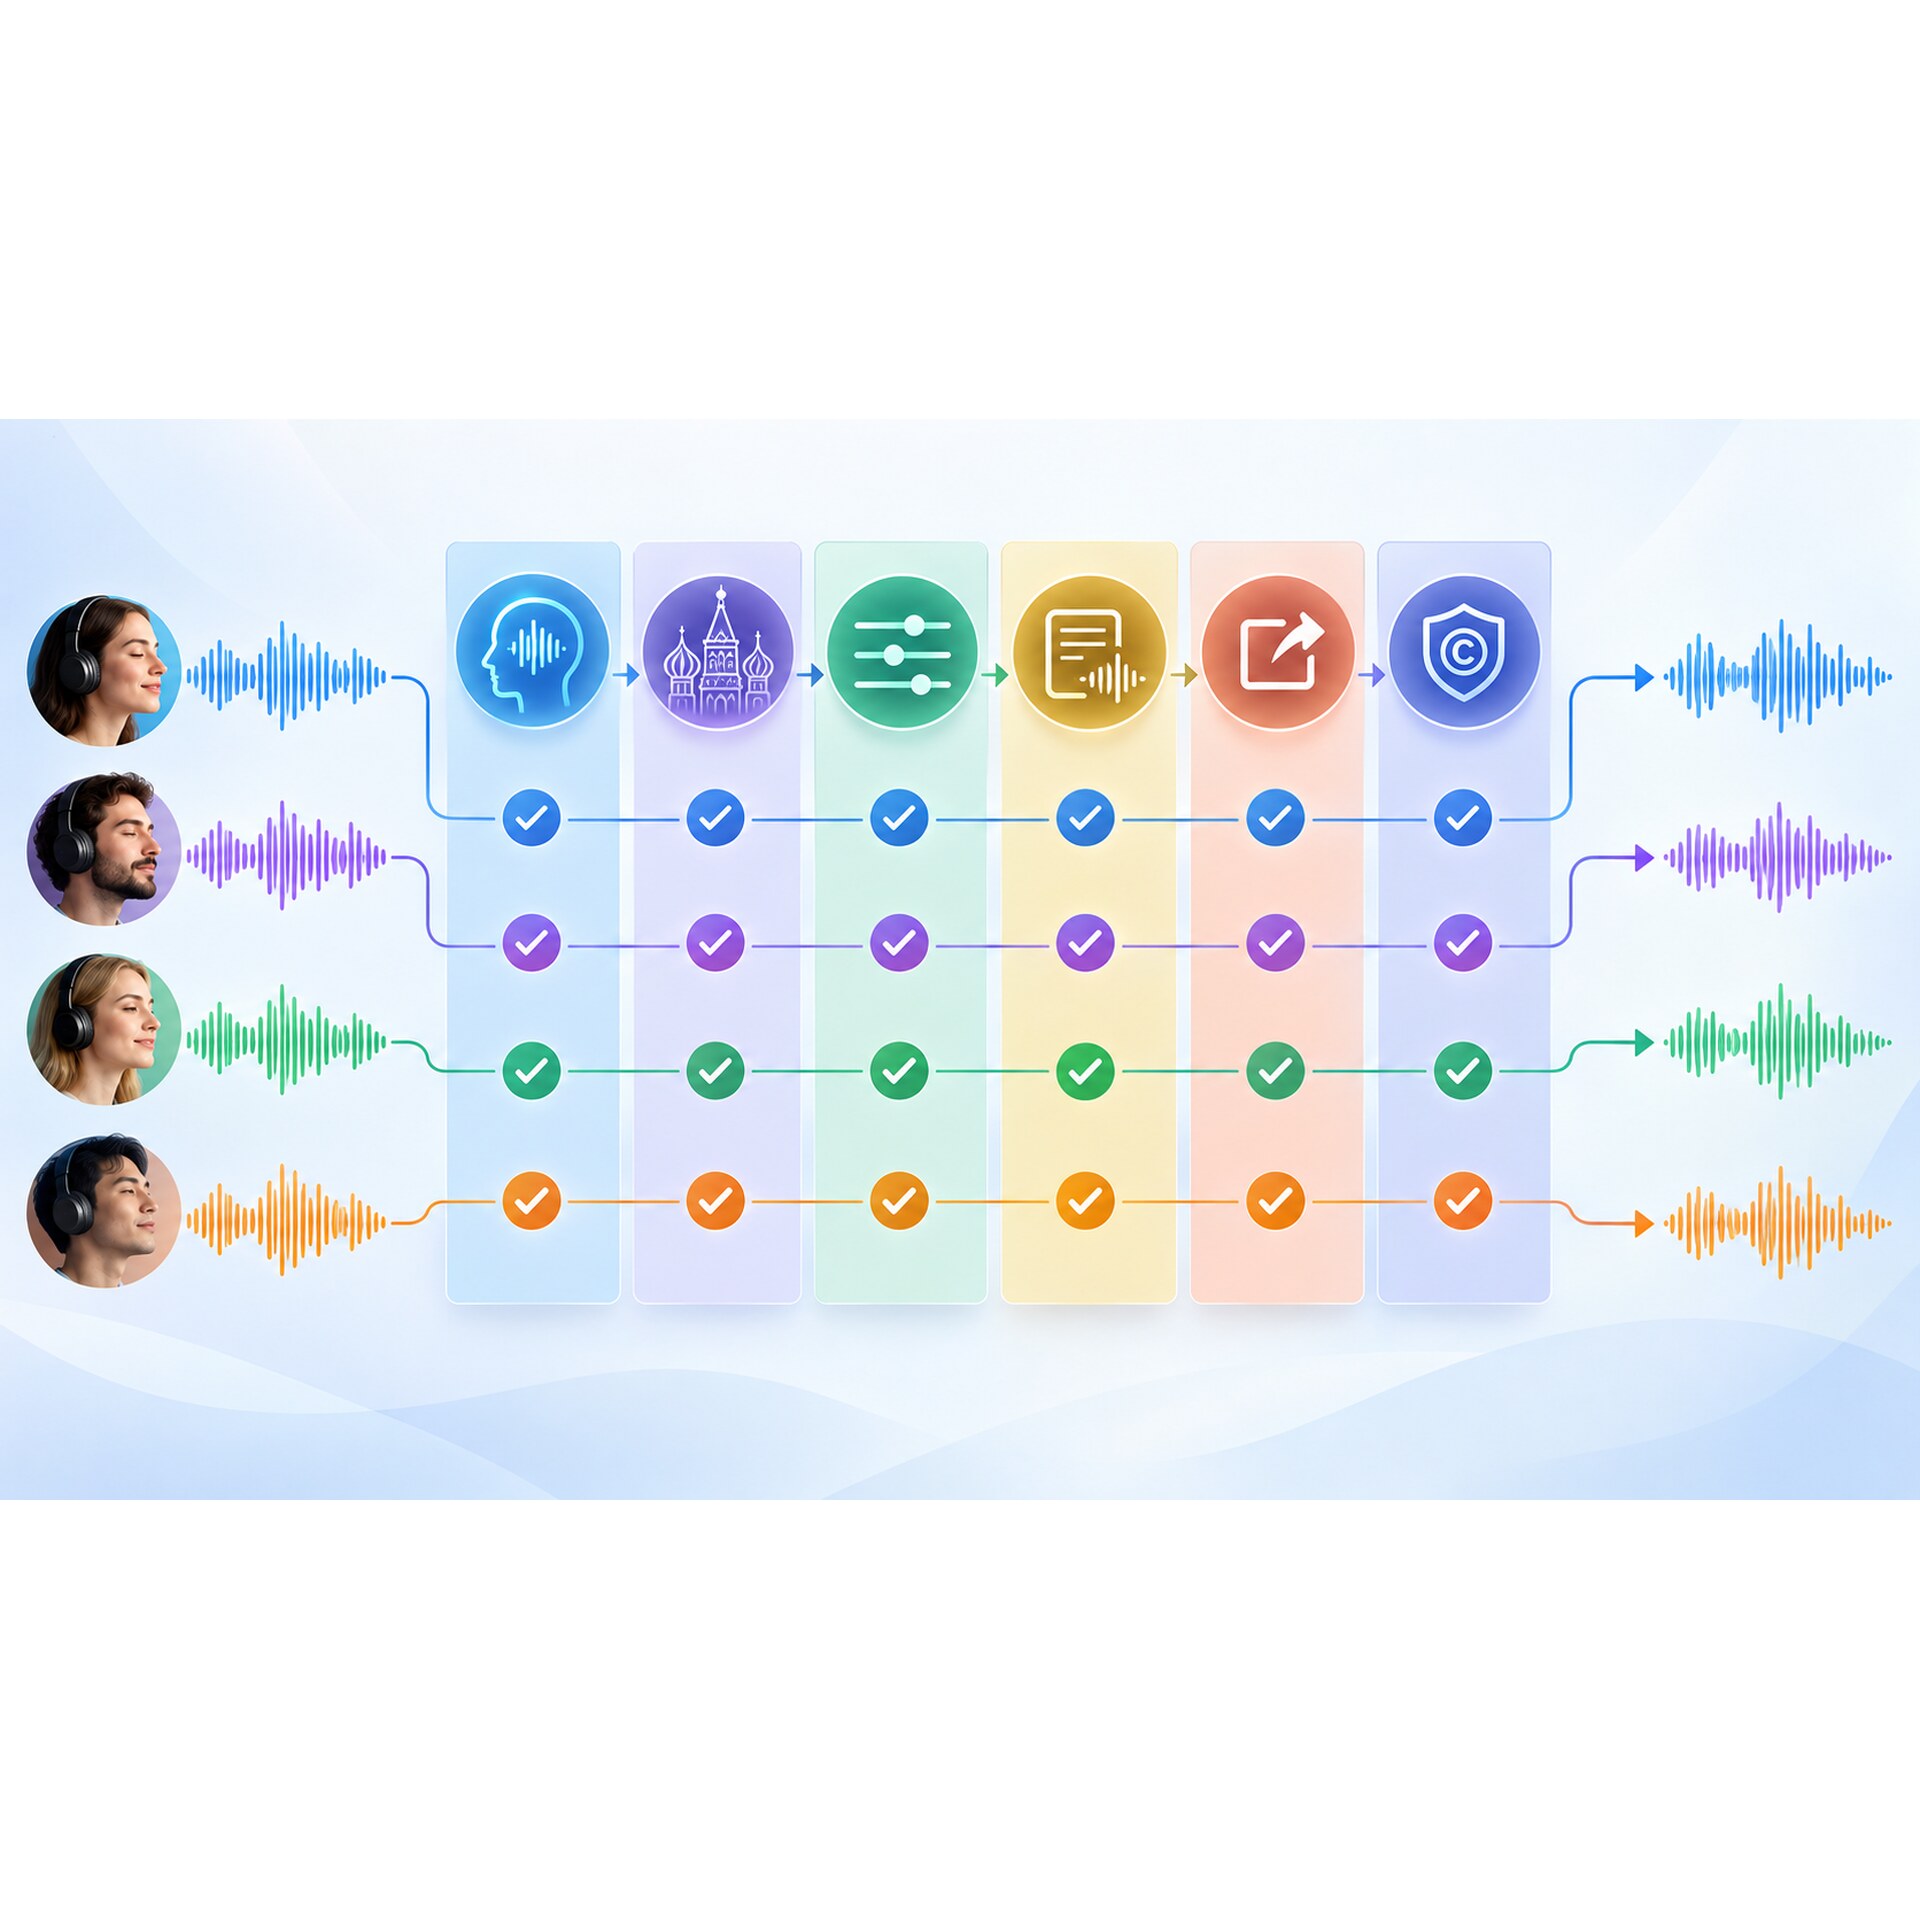
Методика: восемь параметров сравнения сервисов озвучки текста
Параметры расположены в порядке, в котором срабатывают: первые три определяют, можно ли слушать результат, следующие три — встроится ли он в работу, последние два — не придётся ли переделывать проект позже.
- Поддержка русского языка и корректность ударений.
- Натуральность звучания и наличие артефактов.
- Набор настроек: скорость, паузы, интонация, тон, эмоциональность.
- Форматы на выходе и способ загрузки исходника.
- Длина текста за одну генерацию.
- Доступность оплаты из России.
- Права на результат и условия коммерческого использования.
- Поддержка и скорость обработки.
Сравнение сервисов озвучки по этим пунктам занимает вечер и экономит недели. Каждый проверяется на одном тестовом фрагменте, иначе сравниваются не движки, а тексты. Фрагмент собирается заранее: абзац с парой омографов, суммой в косвенном падеже, датой, двумя аббревиатурами и длинным предложением.
Параметр 1. Поддержка русского языка и ударения
Поддержка русского языка в описании сервиса и качественный русский синтез — разные вещи. Формально язык поддерживают почти все крупные движки, но одни обучены на большом русском корпусе, а другие используют русский как один из полутора сотен языков с общей моделью.
Омографы. Слова, которые пишутся одинаково, а произносятся по-разному в зависимости от смысла. Движок, обученный на русском, чаще угадывает их по контексту; универсальный — почти никогда.
Числительные в косвенных падежах. «Скидка на 70 %» и «дороже на 70 %» требуют разных форм: слабый синтез читает символ процента в именительном падеже и разрушает фразу.
Ручная простановка ударения. Ключевой пункт: если вмешаться в произношение нельзя, ошибка становится неисправимой без переписывания текста. Рычаг влияния ценнее красивого демо.
Параметр 2. Натуральность и артефакты: как слушать демо озвучки
Демо на сайте записано на идеальном тексте и подобрано под сильные стороны движка. Смысл имеет только свой фрагмент, прослушанный в наушниках. Что искать на слух.
Проглатывание окончаний в конце фразы, особенно на повышенной скорости.
Обрыв дыхания: вдоха нет там, где его делает человек, и длинная фраза звучит механически ровно.
Утвердительный контур там, где стоит знак вопроса.
Качество синтеза оценивается не по первым десяти секундам, а по третьей минуте: усталость от неестественного голоса накапливается. Отдельно проверяется повторяемость — если фраза при двух генерациях звучит по-разному, длинный материал из кусков не собрать.
Параметр 3. Набор настроек озвучки: скорость, паузы, интонация, тон
Настройки отличают инструмент от игрушки. Минимальный рабочий набор выглядит так.
Скорость и темп. Инструкция и реклама требуют разной подачи, одного ползунка на весь материал недостаточно — нужна правка по фрагментам.
Паузы. Синтез останавливается на знаках препинания; смысловая пауза перед важной цифрой задаётся вручную либо не появляется вовсе.
Интонация и тон. Нейтральный регистр для справки, тёплый для приветствия, сухой для юридического текста: один вариант подачи делает весь материал одинаково ровным.
Эмоциональность. Параметр, который чаще всего перекручивают: избыток эмоции в обучающем модуле утомляет сильнее, чем её недостаток.
В КупиГолос доступны скорость и темп, паузы, интонация, ударения, тон и стиль, тембр и эмоциональность. Варианты подачи слушают в библиотеке голосов сервиса, полный набор инструментов собран в витрине ИИ-функций платформы.
Параметр 4. Форматы на выходе и файлы на входе для озвучки текста
Пункт кажется техническим, но именно он чаще всего останавливает работу на финише.
MP3 против WAV. MP3 удобен для публикации, WAV нужен там, где дорожку ещё обрабатывают: сводят с музыкой, чистят, монтируют под видео. Сервис, отдающий только сжатый файл, годится для черновика и не годится для монтажа.
Загрузка исходника файлом. Ввод только в поле формы означает ручное копирование по кускам. Приём .txt и .docx экономит часы на объёмных проектах.
В КупиГолос на выходе доступны MP3 и WAV, на входе текст принимается файлами .txt и .docx. Перед загрузкой документа стоит вычистить колонтитулы и подписи к иллюстрациям: они попадут в дорожку наравне с основным текстом.
Параметр 5. Длина текста за одну генерацию
Самый недооценённый параметр: он определяет не удобство, а звучание финального материала.
Если сервис принимает за раз небольшой фрагмент, длинный текст придётся резать и склеивать. На стыках проявляются три проблемы: разная громкость соседних кусков, разный темп и разная интонационная высота. Слушатель не поймёт, что не так, но услышит шов.
Что выясняется до начала работы:
- какой объём принимается за одну генерацию;
- сохраняются ли настройки голоса между генерациями;
- есть ли склейка внутри сервиса или дорожки собираются во внешнем редакторе.
Для статьи на три тысячи знаков вопрос неактуален, для аудиокниги или курса он определяет, сколько часов уйдёт на сборку. Предельная длина одной генерации в КупиГолос уточняется в сервисе; известно другое — короткий текст до 1 000 символов обрабатывается менее чем за 5 секунд, и это позволяет дёшево проверять фрагменты до запуска всего объёма.
Параметр 6. Оплата из России и доступ к сервису озвучки
Параметр, который в зарубежных обзорах не упоминается, а в российской практике отсекает кандидатов быстрее остальных. Проверяются три вещи.
Принимается ли российская карта. Не «есть ли платная подписка», а проходит ли конкретный платёж.
Выставляется ли счёт юридическому лицу. Для компании оплата с расчётного счёта и закрывающие документы часто важнее самой цены.
Что происходит при продлении. Разовый платёж проходит, автоматическое списание через месяц — нет, и доступ обрывается в середине проекта.
Платформа КупиГолос работает из России прямо в браузере, оплата проходит российскими картами. По калькулятору на 10 сентября 2026 года разовая озвучка указана как 0 ₽, вариант с тарифом — 20 ₽ с пометкой «выгоднее на 70 %»; состав пакетов и лимиты уточняются в сервисе. Кредиты в подписке общие на все инструменты платформы.
Параметр 7. Права на результат и коммерческое использование озвучки
Самый дорогой в исправлении параметр: ошибка обнаруживается после публикации.
Условия модели и тарифа. Использовать готовое аудио в коммерческом проекте можно, если это разрешено условиями конкретной модели и тарифа; бесплатный доступ нередко предполагает только ознакомительное применение.
Права на исходную запись. Для чужих голосов и загруженных образцов требуется право на исходный материал — и для знаменитого голоса, и для записи коллеги «на пробу».
Ограничения по содержанию. Поддельные обращения и рекомендации от имени реальных людей недопустимы: приписывать человеку чужие слова нельзя независимо от инструмента.
Подтверждающие документы. Для рекламы в эфире может понадобиться документ о правомерности воспроизведения — в студийной практике КупиГолос это паспорт ролика, он запрашивается при заказе.
Отдельная деталь: клонирование голоса на сайте платформы обозначено разделом, но помечено как готовящееся. На дату сверки это не работающая функция продукта, и планировать проект под неё нельзя.
Параметр 8. Поддержка и скорость обработки текста
Два свойства, которые проявляются в один момент — когда что-то пошло не так.
Скорость обработки определяет стиль работы. Если фрагмент считается секунды, текст правится итеративно: послушал, поправил ударение, перегенерировал. Если минуты — правки копятся пачками, что хуже по результату.
Поддержка проверяется до оплаты: есть ли канал связи на русском, в какое время он работает, отвечает ли на технические вопросы человек. Форма обратной связи без сроков ответа — это отсутствие поддержки.
Для проектов со сроком добавляется эскалация: у чистых ИИ-сервисов её нет по определению, у платформ с собственной студией есть запасной маршрут. В КупиГолос заявки принимаются в будни с 10:00 до 19:00, телефон 8 800 200-45-51.
Число голосов против чтения чисел и аббревиатур: что важнее в озвучке
Первое, чем меряются подборки, — количество голосов в каталоге. Показатель почти пустой: в проекте используется один голос, максимум три. Большая часть каталога приходится на другие языки, часть позиций различается косметически. И широкий набор почти всегда неравномерен: русские голоса в каталоге на сто языков редко доведены до уровня английских. Считать полезнее пригодные русские голоса под конкретный тип материала.
Решает другое — чтение чисел и сокращений на русском. Смета, дата, процент, телефон, отраслевая аббревиатура встречаются почти в любом деловом тексте, и движок, который читает «10.09.2026» как набор чисел с точками, создаёт правку в каждом втором абзаце.
Каталог из тридцати голосов, где синтез справляется с числительными, обходится дешевле каталога из трёхсот, где каждую сумму приходится переписывать словами. Три ошибки на абзац при объёме в сотню страниц — это отдельная работа редактора, которой в смете нет.
Обзор ИИ для озвучки текста: восемь движков со страницами разбора
Характеристика идёт по специализации: тарифы и лимиты сторонних сервисов сверяются на странице самого сервиса. Задача обзора — показать, какой сценарий закрывает каждый движок.
ElevenLabs
Движок, который чаще всего упоминают в разговоре о натуральности: выразительная подача и работа с эмоцией, отсюда подкасты, аудиокниги и художественные форматы. Что уточнять: условия коммерческого использования и оплату. Подробности — на странице разбора модели ElevenLabs.
Murf
Инструмент для деловых задач: презентации, обучающие модули, корпоративное видео. Акцент на редакторе, где дорожка выстраивается по блокам и подгоняется под слайды, то есть на контенте с повторяемой структурой. Что уточнять: русский язык и права. Специфика описана в разборе сервиса Murf.
Speechify
Продукт вырос из сценария «прослушать документ»: статьи, книги и рабочие файлы читаются вслух на ходу, отсюда упор на мобильность, а не на продакшн-качество. Что уточнять: пригодность выгрузки для публикации. Отдельная страница — обзор Speechify.
Fish Audio
Открытая экосистема моделей синтеза и гибкая настройка — для тех, кто собирает процесс под себя и ценит управляемость выше готовности из коробки. Что уточнять: стабильность русского произношения и лицензию модели.
Yandex SpeechKit
Российский облачный стек синтеза и распознавания. Сильная сторона для русскоязычных задач: нормализация чисел, дат и сокращений заложена в движок, а не достраивается редактурой. Сценарий — интеграция в собственный продукт, телефония, голосовые интерфейсы. Что уточнять: формат подключения, работа идёт через облако, а не через окно ввода. Подробнее — на странице разбора Yandex SpeechKit.
SaluteSpeech
Ещё один российский стек синтеза и распознавания для корпоративного контура: голосовые помощники, телефонные меню, обработка обращений. Что уточнять: условия подключения и оформление доступа.
MiniMax Audio
Мультиязычный синтез с акцентом на выразительность: заметен там, где нужен нестандартный характер голоса и несколько языков сразу. Что уточнять: русское произношение на собственном тексте и оплату.
OpenAI Whisper
Уточнение, потому что путаница встречается постоянно: Whisper — это распознавание речи, а не синтез. Он переводит аудио в текст, а не текст в аудио, и в подборках «сервисов озвучки» появляется по недоразумению. Его сценарий обратный: расшифровка интервью, субтитры, перевод записи в текст, который потом редактируют и уже затем озвучивают другим инструментом.
Таблица: сервисы озвучки текста, специализация и что проверить перед выбором
| Сервис | На чём специализируется | Что проверить перед выбором |
|---|---|---|
| ElevenLabs | Выразительный синтез для нарратива: подкасты, аудиокниги | Права на коммерческое использование, оплату, ударения |
| Murf | Деловой контент: презентации, обучающие модули, видео | Русский голос, права на результат, форматы выгрузки |
| Speechify | Чтение вслух документов и статей для личного потребления | Пригодность дорожки для публикации |
| Fish Audio | Открытые модели синтеза и гибкая настройка | Стабильность русского произношения, лицензию модели |
| Yandex SpeechKit | Российский облачный синтез и распознавание, голосовые интерфейсы | Формат подключения, объём интеграции |
| SaluteSpeech | Российский корпоративный контур: боты, телефония, обращения | Условия подключения и оформление доступа |
| MiniMax Audio | Мультиязычный выразительный синтез | Русское произношение на своём фрагменте, оплату |
| OpenAI Whisper | Распознавание речи: аудио в текст. Синтезом не является | Что задача про расшифровку, а не про озвучивание |
| КупиГолос | Озвучка в браузере с оплатой российскими картами плюс живые дикторы | Актуальные тарифы и лимиты в сервисе |
Тарифы в таблицу намеренно не вынесены: у сторонних сервисов они меняются независимо от даты обзора. Данные по КупиГолос сверены 10 сентября 2026 года.
Кому что подходит: четыре профиля и решающий параметр озвучки
Один и тот же набор параметров даёт разные ответы в зависимости от задачи.
Ролик на один раз. Поздравление, видео к событию, тест рекламы. Решает скорость входа: вставить текст, выбрать голос, получить файл за минуты. Второй параметр — оплата: годовая подписка ради одной минуты аудио бессмысленна.
Регулярный контент. Еженедельные выпуски, соцсети, дайджесты. Решает повторяемость: голос должен звучать одинаково через месяц и через полгода. Дальше идут скорость обработки и удобство правок. Каталог почти не важен, используется один-два голоса.
Обучающие материалы. Курсы, инструкции, регламенты. Решают чтение чисел, дат и терминологии и возможность точечно переозвучить абзац при обновлении программы: сервис, где ради одной цифры перегенерируется весь модуль, не подходит. Критична и длина текста за одну генерацию. Такие задачи закрывает озвучка курсов и инструкций.
Коммерческая реклама. Ролики в эфире, наружная и интернет-реклама, аудиоспоты. Решают права: разрешают ли условия модели и тарифа коммерческое использование и есть ли документ о правомерности воспроизведения. Второй фактор — актёрская подача: имиджевый ролик держится на игре голосом, и здесь синтез уступает живому диктору.
Место КупиГолос: озвучка текста в браузере и живые дикторы
Позиция без превосходных степеней: платформа закрывает сценарий «нужен нормальный русский голос быстро и с оплатой из России». Что известно на 10 сентября 2026 года:
- работа прямо в браузере, оплата российскими картами;
- по калькулятору разовая озвучка — 0 ₽, вариант с тарифом — 20 ₽, «выгоднее на 70 %»;
- 60 языков и 45 диалектов, более 30 голосов на русском, английском, немецком, французском и других языках;
- голоса мужские, женские, детские и характерные, бесплатные и премиум;
- на входе .txt и .docx, на выходе MP3 и WAV;
- настройки: скорость и темп, паузы, интонация, ударения, тон и стиль, тембр, эмоциональность;
- короткий текст до 1 000 символов обрабатывается менее чем за 5 секунд;
- единая подписка: кредиты общие на все инструменты платформы.
Состав пакетов, размер бесплатного лимита и предельная длина одной генерации уточняются в сервисе — эти значения не публикуются именно потому, что меняются.
Отличие, которого нет у чистых ИИ-сервисов: за платформой стоит студия озвучивания, работающая восемь лет, с более чем 15 000 проектов и базой более 2 000 дикторов. Практический смысл — в маршруте отступления: если синтез не вытянул имиджевый ролик, задача передаётся человеку без смены подрядчика. Промежуточный вариант — подборка нейроголосов с фильтром по языкам: 9 позиций, все от 30 ₽. Для сравнения: студийная запись живым диктором оценивается в 500-3 000 и более рублей за минуту, сроки студии — от 30 минут до нескольких дней.
Проверяется связка на своём материале: онлайн-генерация озвучки по тексту считает короткий фрагмент за секунды.
На чём обжигаются при выборе сервиса озвучки текста
Пять промахов, каждый из которых стоит переделки проекта.
Права и коммерческое использование. Дорожка сделана на бесплатном доступе и уходит в рекламу. Коммерческое применение допустимо, когда его разрешают условия модели и тарифа, а для загруженного образца чужого голоса нужно право на исходную запись. Проверяется это до записи, а не после публикации.
Оплата из России. Проект начинается на пробном доступе, а на середине упирается в невозможность оплатить продление: материал переозвучивается в другом сервисе, и голос по всему курсу меняется.
Русские ударения. Движок выбирается по английскому демо, а работать с ним предстоит на русском. Проверка идёт на своём абзаце с омографами, суммами и датами.
Длина текста. Лимит на одну генерацию выясняется, когда книга уже в работе. Дальше — ручная нарезка, склейка и слышимые швы.
Поддержка. Пока всё работает, канал связи не нужен. Он нужен в день сдачи, когда генерация падает с ошибкой.
Шестой промах не про сервис, а про ожидания: синтез не заменяет актёрскую игру, художественный дубляж и имиджевая реклама остаются зоной живого голоса. После такой проверки вопрос «какой сервис выбрать» становится арифметическим: у одного кандидата два минуса, у другого пять.
FAQ: лучшие ИИ для озвучки текста — методика, сервисы и границы
С чего начинать сравнение, если сервисов десятки?
С параметров, которые отсекают кандидатов целиком: оплата и качество русского произношения. Оба проверяются за десять минут и снимают большую часть списка.
Почему количество голосов — плохой критерий?
Потому что в работе используется один-три голоса, а широкий каталог неравномерен по качеству и заполнен другими языками. Полезнее считать пригодные русские голоса.
Как проверить, справится ли движок с русским текстом?
Прогнать собственный абзац с омографами, суммой в косвенном падеже, датой и аббревиатурами: демо с сайта для этого не подходит.
Whisper подходит для озвучки текста?
Нет. OpenAI Whisper распознаёт речь и превращает аудио в текст, то есть решает обратную задачу — для синтеза нужен другой инструмент.
Чем ElevenLabs отличается от Murf по назначению?
Первый чаще выбирают за выразительность в длинном нарративе, второй — за деловой контент: презентации и обучающие модули. Тарифы обоих проверяются на их страницах.
Что делать, если текст длиннее лимита одной генерации?
Резать по смысловым блокам, а не по символам, сохранять настройки голоса и проверять стыки на слух: швы слышны именно на границах фрагментов.
Можно ли использовать синтезированный голос в рекламе?
Только когда это разрешают условия модели и тарифа. Для чужих голосов и загруженных образцов дополнительно нужно право на исходную запись.
Есть ли смысл комбинировать синтез и живого диктора?
Да: черновик и типовые фрагменты озвучиваются синтезом, имиджевая часть отдаётся человеку. Маршрут проще, когда обе услуги у одного подрядчика.
Как часто нужно пересматривать выбор сервиса?
При смене задачи и при обновлении условий: тарифы и лимиты сверяются на странице сервиса перед крупным проектом, а не по дате обзора.
Итог: лучшие ИИ для озвучки текста — как выбрать по методике, а не по позиции в списке
Полезен не рейтинг, а восемь параметров: русский язык и ударения, натуральность и артефакты, набор настроек, форматы на входе и выходе, длина одной генерации, оплата из России, права на результат, поддержка и скорость обработки. Проверка идёт на собственном тестовом абзаце, одинаковом для всех кандидатов.
Число голосов в каталоге почти ничего не говорит о пригодности сервиса, а корректное чтение чисел, дат и сокращений на русском — почти всё: именно там возникает работа редактора, которой нет в смете.
Движки различаются специализацией, а не местом в списке: ElevenLabs — выразительный нарратив, Murf — деловой контент, Speechify — чтение вслух, Fish Audio — гибкая настройка, Yandex SpeechKit и SaluteSpeech — российские интеграции, MiniMax Audio — мультиязычные задачи, а OpenAI Whisper решает обратную задачу распознавания.
Данные по КупиГолос сверены 10 сентября 2026 года: работа в браузере с оплатой российскими картами, разовая озвучка 0 ₽ и 20 ₽ с тарифом, 60 языков и 45 диалектов, более 30 голосов, MP3 и WAV на выходе, .txt и .docx на входе. Пакеты и лимиты уточняются перед запуском проекта, а живые дикторы остаются запасным маршрутом у того же подрядчика — сделать пробную озвучку можно на коротком фрагменте.
Читайте также: как работает синтез речи и что учесть при подготовке текста и пошаговый чек-лист выбора диктора.