




ИИ озвучка текста ломается не в момент генерации, а в момент, когда в поле ввода попадает документ, написанный для глаз. Движок произносит ровно то, что видит: «в 2026 году» он способен выдать как «в две тысячи двадцать шесть году», «1 500 ₽» — как «один пятьсот рублей», а слово «замок» в предложении без подсказок озвучит наугад. Править такое в готовом аудио бессмысленно, правится исходник. Послушать, как звучит подготовленный фрагмент, можно сразу в нейроозвучке онлайн.
Дальше — практикум по пяти классам поломок: ударения и омографы, числа, аббревиатуры и латиница, паузы и ритм, интонация. Каждый блок построен одинаково: что ломается, почему и примеры «было — стало».
Как устроен синтез изнутри, здесь не разбирается: механика описана в отдельном материале блога. Эта статья про редактуру — что вычитать до нажатия кнопки.
В статье:
- почему одно слово в двух предложениях читается по-разному и как этим управлять;
- как записать число, дату, сумму и телефон, чтобы они прозвучали нужным падежом;
- что расшифровывать вручную: аббревиатуры, латиница, домены, названия брендов;
- где синтез не поставит паузу сам и как разбить длинную фразу;
- таблица «что ломается — почему — как исправить» и чек-лист вычитки на десять пунктов.
Почему ии озвучка текста спотыкается на исходнике, а не на движке
Синтез речи не понимает смысл фразы. Он предсказывает произношение по статистике: какие звуки идут за такой последовательностью букв, где в похожих конструкциях стоит ударение. Пока текст типовой, предсказание попадает в цель. Появляется неоднозначность — выбор делает движок, а не автор.
Отсюда правило: всё, что человек достраивает из контекста и вёрстки, синтезу нужно сообщить буквами. Читатель видит колонку «руб.» и понимает, что «2 500» — это рубли; синтез видит цифры и разбирает узкое окно вокруг слова.
Второе — про формат. В письменном тексте нормальны длинные периоды со скобками: глаз возвращается назад. В озвучке возврата нет. Подготовка текста к озвучке — это превращение письменной конструкции в устную.
Третье — про проверку. Ошибка озвучки не видна, она слышна. Рабочий цикл: фрагмент на 3-5 предложений, генерация, прослушивание, правка, повтор.
Ударения и омографы: первая поломка в озвучке текста
Омографы — слова с одинаковым написанием и разным ударением. Их сотни, и большая часть встречается в деловых текстах, а не в поэзии. Набор, который проверяется всегда:
- за́мок и замо́к: сооружение и запирающее устройство;
- до́рог (родительный от «дороги») и доро́г (краткое прилагательное);
- бо́льшая (сравнение) и больша́я (размер);
- о́рган (власти) и орга́н (инструмент);
- ви́дение (способность) и виде́ние (образ).
Почему одно слово в разных предложениях читается по-разному: движок опирается на ближайшие слова. «Открыл замок ключом» и «продал замок в Шотландии» — подсказки сильные, ошибки не будет. Во фразе «Замок оказался старым» подсказки нет, и результат в двух генерациях может выпасть по-разному.
Было: «Замок не поддавался.» → Стало: «Дверной замо́к не поддавался.»
Было: «Большая часть бюджета ушла на продакшен.» → Стало: «Бо́льшая часть бюджета ушла на продакшен.» Без пометки читается «больша́я», и смысл сравнения теряется.
Отдельная категория — имена собственные: фамилии и топонимы движок ставит по общей статистике, а ударение у них часто нетипичное. Каждое имя проверяется первой тестовой генерацией.
Как пометить ударение в тексте: рабочие приёмы для озвучки
Способов четыре. Набор допустимых пометок зависит от модели и уточняется в сервисе, поэтому нотация проверяется на коротком фрагменте.
Знак ударения над гласной. Ставится сразу после ударной буквы: «замо́к», «бо́льшая». Текст остаётся читаемым, но символ теряется при копировании между редакторами.
Знак «+» перед ударной гласной. Запись «зам+ок» переживает любое копирование. Если нотация не поддержана, плюс прозвучит вслух — слышно на первом превью.
Заглавная ударная гласная. «ЗамОк» годится для черновиков: работает не везде и портит текст.
Переписывание фразы. Самый надёжный способ, потому что не зависит от поддержки разметки. Вместо «дорог» — «стоит дорого», вместо «косит» — «скашивает траву». Ударения в тексте перестают быть проблемой, когда в нём нет слов с двойным чтением.
Было: «Орган принял решение в срок.» → Стало: «Надзорный о́рган принял решение в срок.» Одно слово-подсказка, и разметка не нужна.
В сервисе есть настройка ударений: она правит произношение слова без переписывания абзаца. Как это устроено в интерфейсе перевода текста в речь, видно на первой генерации.
Числа: как записать сумму, чтобы озвучка прочитала нужный падеж
Числа в тексте — вторая по частоте поломка после ударений и первая по заметности. Цифровая запись не содержит грамматики. «1 500» — это и «полторы тысячи», и «одна тысяча пятьсот», а в косвенном падеже ещё и «полутора тысячам».
Первое решение — писать словами везде, где важен падеж или разговорная форма.
Было: «Стоимость курса — 1 500 ₽.» → Стало: «Стоимость курса — полторы тысячи рублей.»
Второе — согласование с существительным. Запись «к 22 сотрудникам» может прозвучать как «к двадцать два сотрудникам».
Было: «Обращение направлено к 22 сотрудникам.» → Стало: «Обращение направлено к двадцати двум сотрудникам.»
Третье — порядковые числительные. Цифра «2026» без окончания читается количественным, и год в предложном падеже разваливается.
Было: «Отчёт сдан в 2026 году.» Возможный результат: «в две тысячи двадцать шесть году». → Стало: «Отчёт сдан в две тысячи двадцать шестом году.»
Было: «Занял 3 место в рейтинге.» → Стало: «Занял третье место в рейтинге.»
Даты, годы и диапазоны в тексте под озвучку
Дата — три числа с разной грамматикой, и цифровой формат не сообщает движку ни одной из них. «10.09.2026» прозвучит как «десять точка ноль девять точка две тысячи двадцать шесть».
Было: «Данные сверены 10.09.2026.» → Стало: «Данные сверены десятого сентября две тысячи двадцать шестого года.»
Диапазоны требуют явной связки: тире между числами читается то как «минус», то как пауза, то игнорируется.
Было: «Приём заявок 10-19.» → Стало: «Приём заявок с десяти до девятнадцати часов.»
Было: «Рост в 2020-2026 гг.» → Стало: «Рост с две тысячи двадцатого по две тысячи двадцать шестой год.» Заодно снимается «гг.», которое прозвучит двумя буквами.
Десятилетия и века — та же логика: «в 1990-х» безопаснее записать как «в девяностые годы», «XX век» — как «двадцатый век». Сокращения «г.», «гг.», «в.» раскрываются словами всегда.
Деньги, проценты, телефоны и дроби: числа в тексте для озвучки
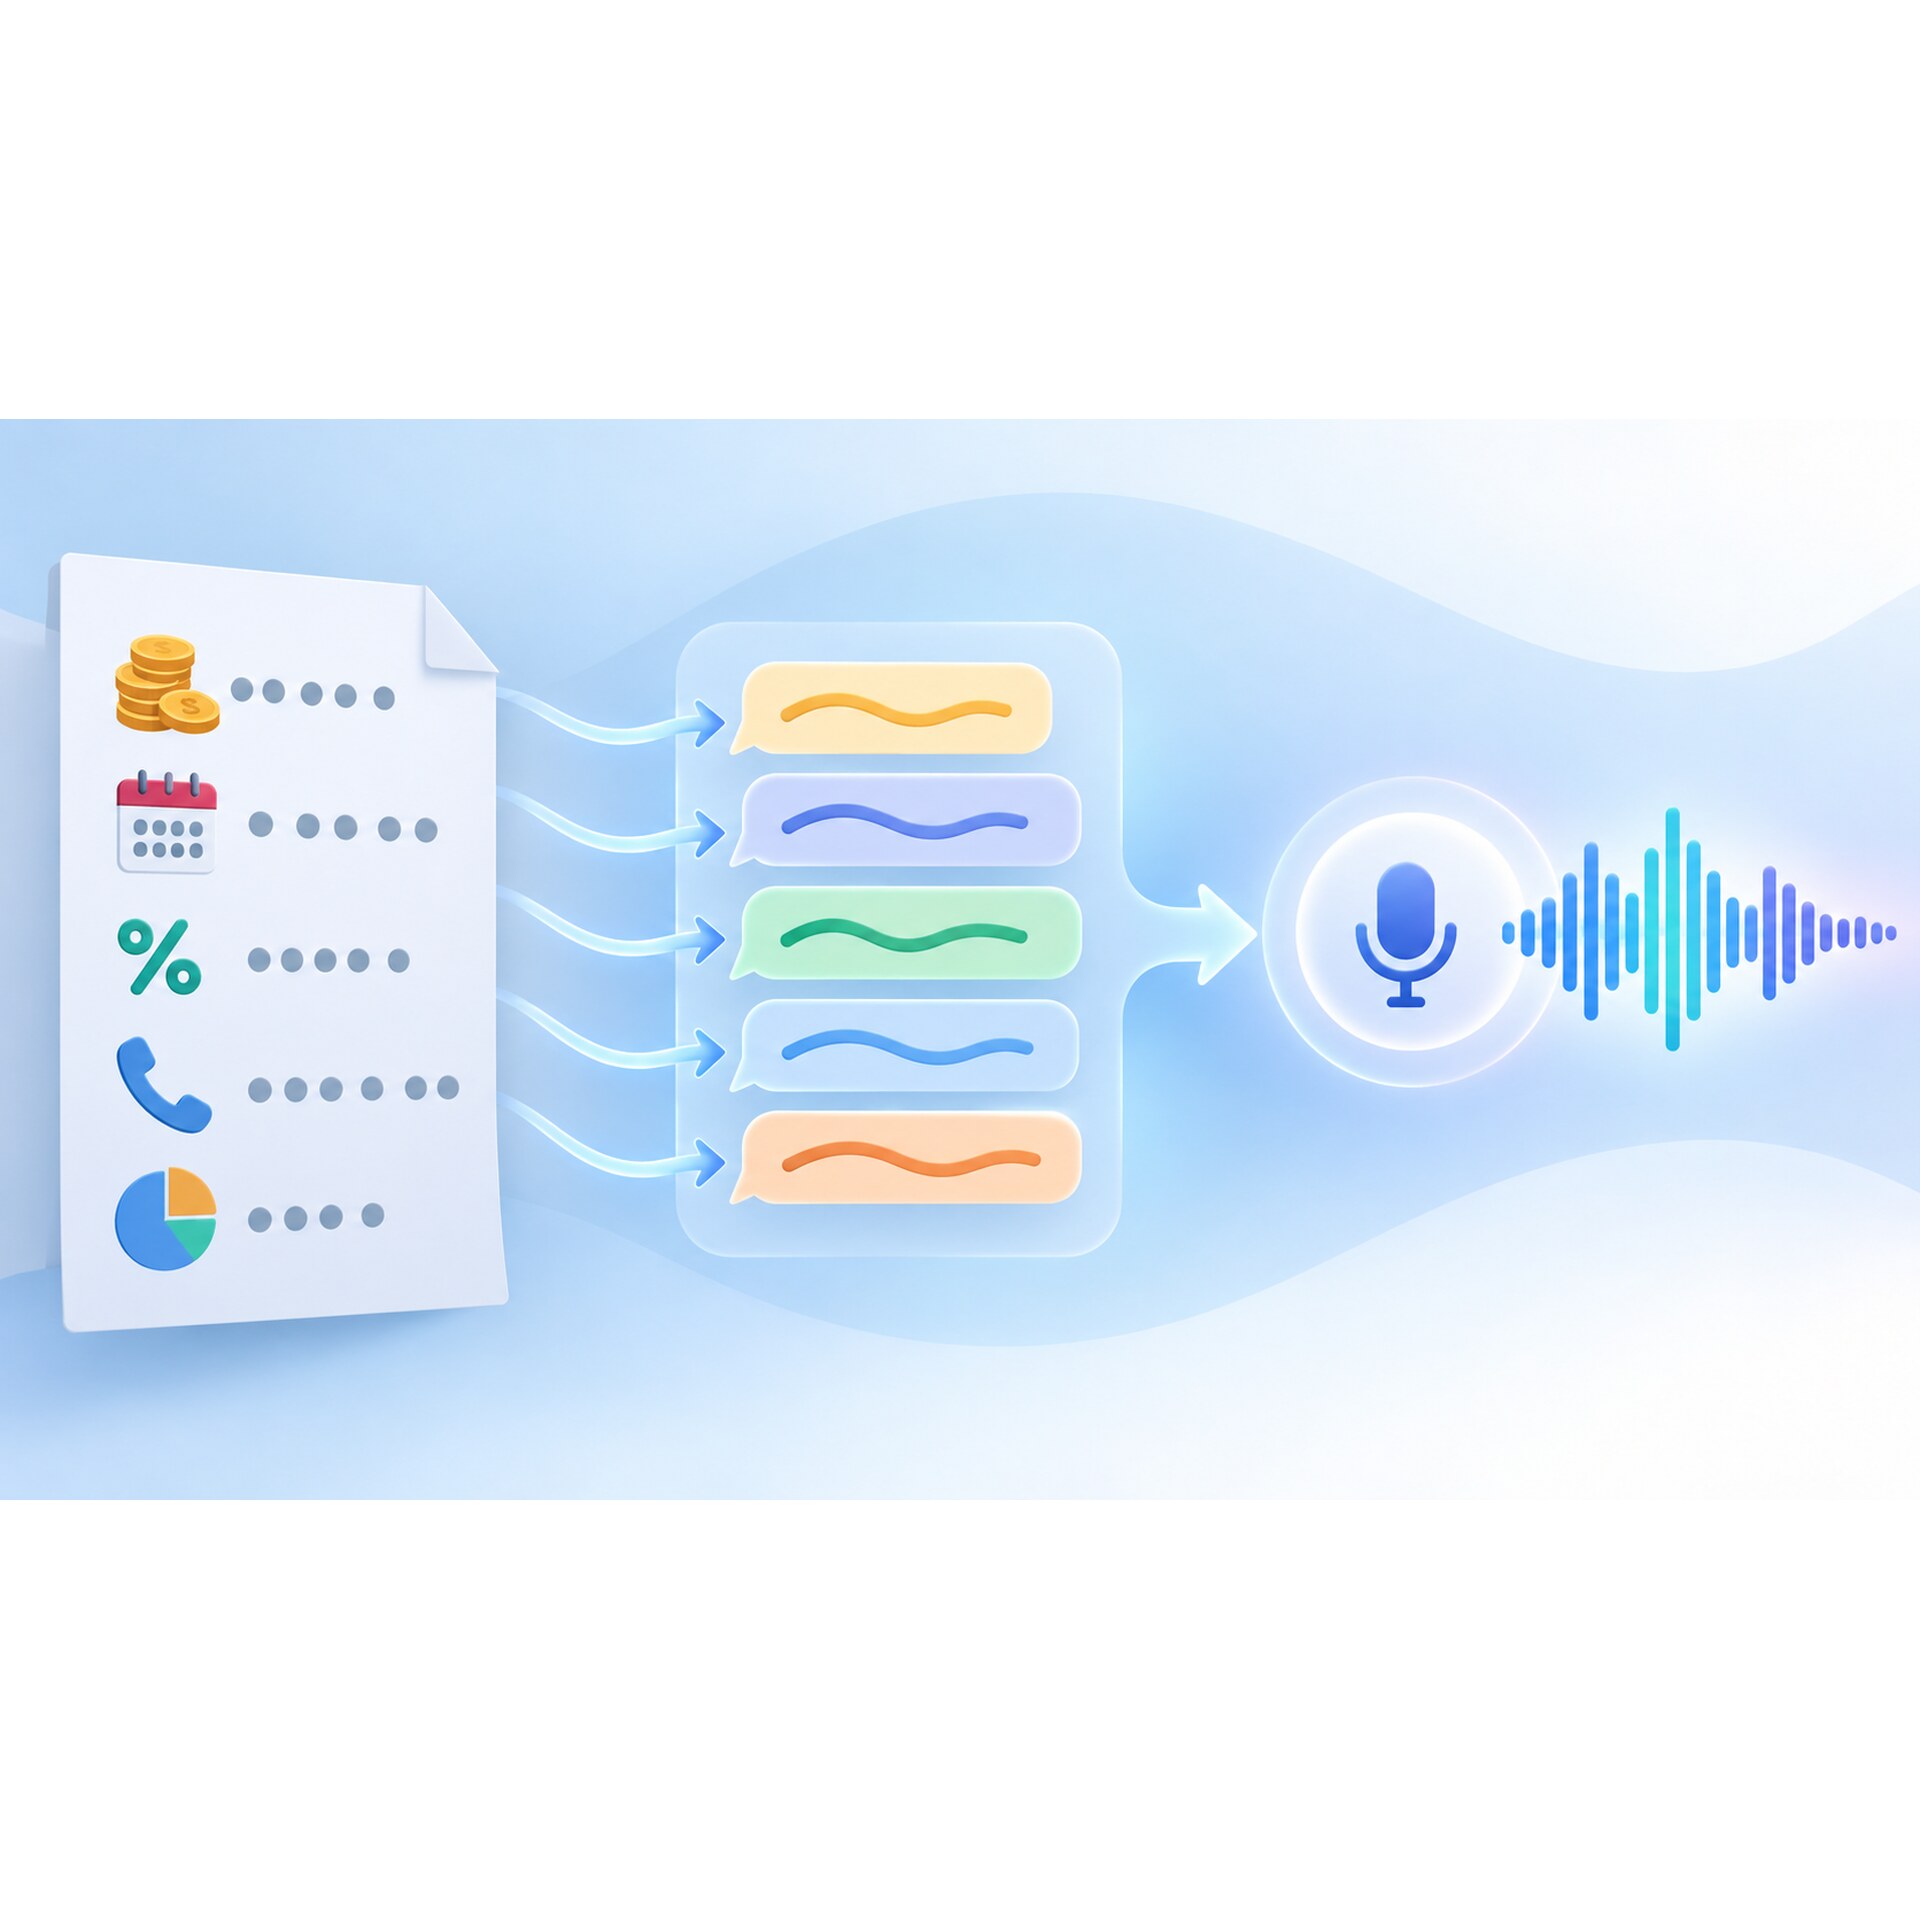
Деньги. Символ валюты читается непредсказуемо, копейки через запятую превращаются в дробь. Надёжно — число и валюта словами.
Было: «Смета выросла до 6 990 ₽.» → Стало: «Смета выросла до шести тысяч девятисот девяноста рублей.»
Проценты. Знак «%» обычно читается в именительном падеже, поэтому конструкции со сравнением ломаются.
Было: «Вариант с тарифом выгоднее на 70 %.» → Стало: «Вариант с тарифом выгоднее на семьдесят процентов.»
Дроби. Запятая и слэш дают разночтения: «2,5 раза» звучит как «два запятая пять раза».
Было: «Ролик длится 2,5 минуты.» → Стало: «Ролик длится две с половиной минуты.»
Телефоны. Номер произносится группами, иначе звучит как одно длинное число. Дефисы синтез трактует свободно, поэтому группы разделяются точками или запятыми — они дают паузу.
Было: «Звоните 8 800 200-45-51.» → Стало: «Звоните: восемь, восемьсот, двести, сорок пять, пятьдесят один.» Для голосового меню такая запись обязательна.
Единицы измерения. «кг», «Гц», «kbps», «дБ» раскрываются словами.
Аббревиатуры и латиница: что расшифровать до озвучки текста
Аббревиатуры делятся на три группы, и обращаться с ними нужно по-разному.
Читаются по буквам. МВД, ФНС, США, НДС, ТЗ. С распространёнными движок справляется, спотыкается на редких и отраслевых. Сокращение, встречающееся один раз, проще раскрыть словами.
Читаются как слово. Вуз, ГОСТ, НАТО, ЗАГС. Ошибка обратная: движок произносит по буквам то, что звучит слитно. Лечится записью строчными.
Требуют ручной расшифровки. Внутренние сокращения, отраслевые термины, буквенно-цифровые обозначения: 4G, B2B, IVR, Q&A. Символ «&» вслух не читается никак.
Было: «Настроили IVR за два дня.» → Стало: «Настроили голосовое меню, то есть систему IVR, за два дня.»
Латиница внутри русского текста. Слово читается по английским правилам там, где нужна русская транскрипция, или наоборот. Названия форматов обычно проходят нормально, но в важных местах надёжнее словами.
Было: «Выгрузка в MP3 и WAV.» → Стало: «Выгрузка в форматах эм-пэ-три и вав.»
Отдельно про «ИИ»: двухбуквенное сокращение в потоке речи сливается и звучит невнятно. В ключевой фразе надёжнее написать «искусственный интеллект».
Бренды, домены и адреса сайтов в озвучке текста
Адрес сайта почти всегда требует переписывания. Точка в домене — не конец предложения, «https» и «www» вслух не нужны, а латинское название читается по правилам языка, который угадает движок.
Было: «Подробности на kupigolos.ru/ai.» → Стало: «Подробности — в разделе искусственного интеллекта на сайте купиголос точка ру.»
Было: «Пишите на info@example.ru.» → Стало: «Пишите на адрес инфо собака экзампл точка ру.»
Правило простое: в озвучке произносится маршрут, а не адрес. Слушатель не запишет строку на слух, ему нужно понять, куда идти, поэтому в аудио уместнее «в разделе с каталогом голосов», а ссылка живёт в описании. Как устроены такие разделы, видно в каталоге голосов платформы.
Названия брендов. Латиница даёт самые заметные ошибки: бренд звучит в первых секундах. Решение — транслитерация кириллицей в том виде, в каком название произносят люди.
Было: «Проект сделан на платформе Kupigolos.» → Стало: «Проект сделан на платформе КупиГолос.»
Паузы и ритм: где ии озвучка текста не остановится сама
Синтез ставит паузы по знакам препинания. Нет знака — нет паузы, и два смысловых блока склеиваются в один поток. Места, где это происходит чаще всего.
Заголовки без точки. В документе заголовок отделён шрифтом, в озвучке он становится началом следующего предложения. Лечится точкой в конце и пустой строкой после.
Было: «Как подготовить текст Первым делом проверьте ударения.» → Стало: «Как подготовить текст. Первым делом проверьте ударения.»
Скобки и сноски. Вставка читается тем же тоном, что основная фраза, и слушатель теряет нить. Содержимое скобок разворачивается в предложение или удаляется.
Было: «Формат вывода (MP3 или WAV, выбирается при экспорте) зависит от задачи.» → Стало: «Формат вывода зависит от задачи. Доступны эм-пэ-три и вав, выбор делается при экспорте.»
Абзацы. Пустая строка для синтеза — сигнал длинной паузы. Текст, залитый монолитом, звучит как речь без вдоха; разбивка по 3-5 предложений даёт ритм без единой настройки.
Точка вместо запятой. Самая действенная правка: запятая даёт короткую паузу и интонацию незавершённости, точка — полную остановку. Паузы в тексте так расставляются быстрее, чем настройками.
Было: «Текст загружается файлом, поддерживаются .txt и .docx, результат скачивается в MP3 или WAV, дальше его можно сводить с музыкой.»
Стало: «Текст загружается файлом. Поддерживаются форматы .txt и .docx. Результат скачивается в эм-пэ-три или вав. Дальше дорожку можно сводить с музыкой.»
Длинное предложение и список: как разбить текст для озвучки
Ориентир для устной речи — 12-15 слов. Что длиннее, слушатель удерживает с трудом, а синтез произносит на одном интонационном контуре, и фраза звучит монотонно. Два приёма разбивки.
Обороты — в отдельное предложение. Конструкция «Пользователь, загрузивший файл .docx и выбравший премиум-голос, получает дорожку» на слух разваливается. Устный вариант: «Пользователь загружает файл .docx и выбирает премиум-голос. Дорожка приходит следом.»
Перечисление через запятую — в список. Список читается лучше не потому, что синтез знает про маркеры, а потому что каждый пункт становится отдельным предложением с точкой и своей интонацией завершения.
Было: «Настроить можно скорость и темп, паузы, интонацию, ударения, тон и стиль, тембр, эмоциональность.»
Стало: «Настроить можно семь параметров. Скорость и темп. Паузы. Интонацию. Ударения. Тон и стиль. Тембр. Эмоциональность.»
Есть и обратная ошибка — рубленые фразы по три слова: такая речь утомляет не меньше монолита. Рабочий ритм — чередование: две-три средние фразы, одна короткая.
Интонация и вопросы: как задать тон озвучке текста
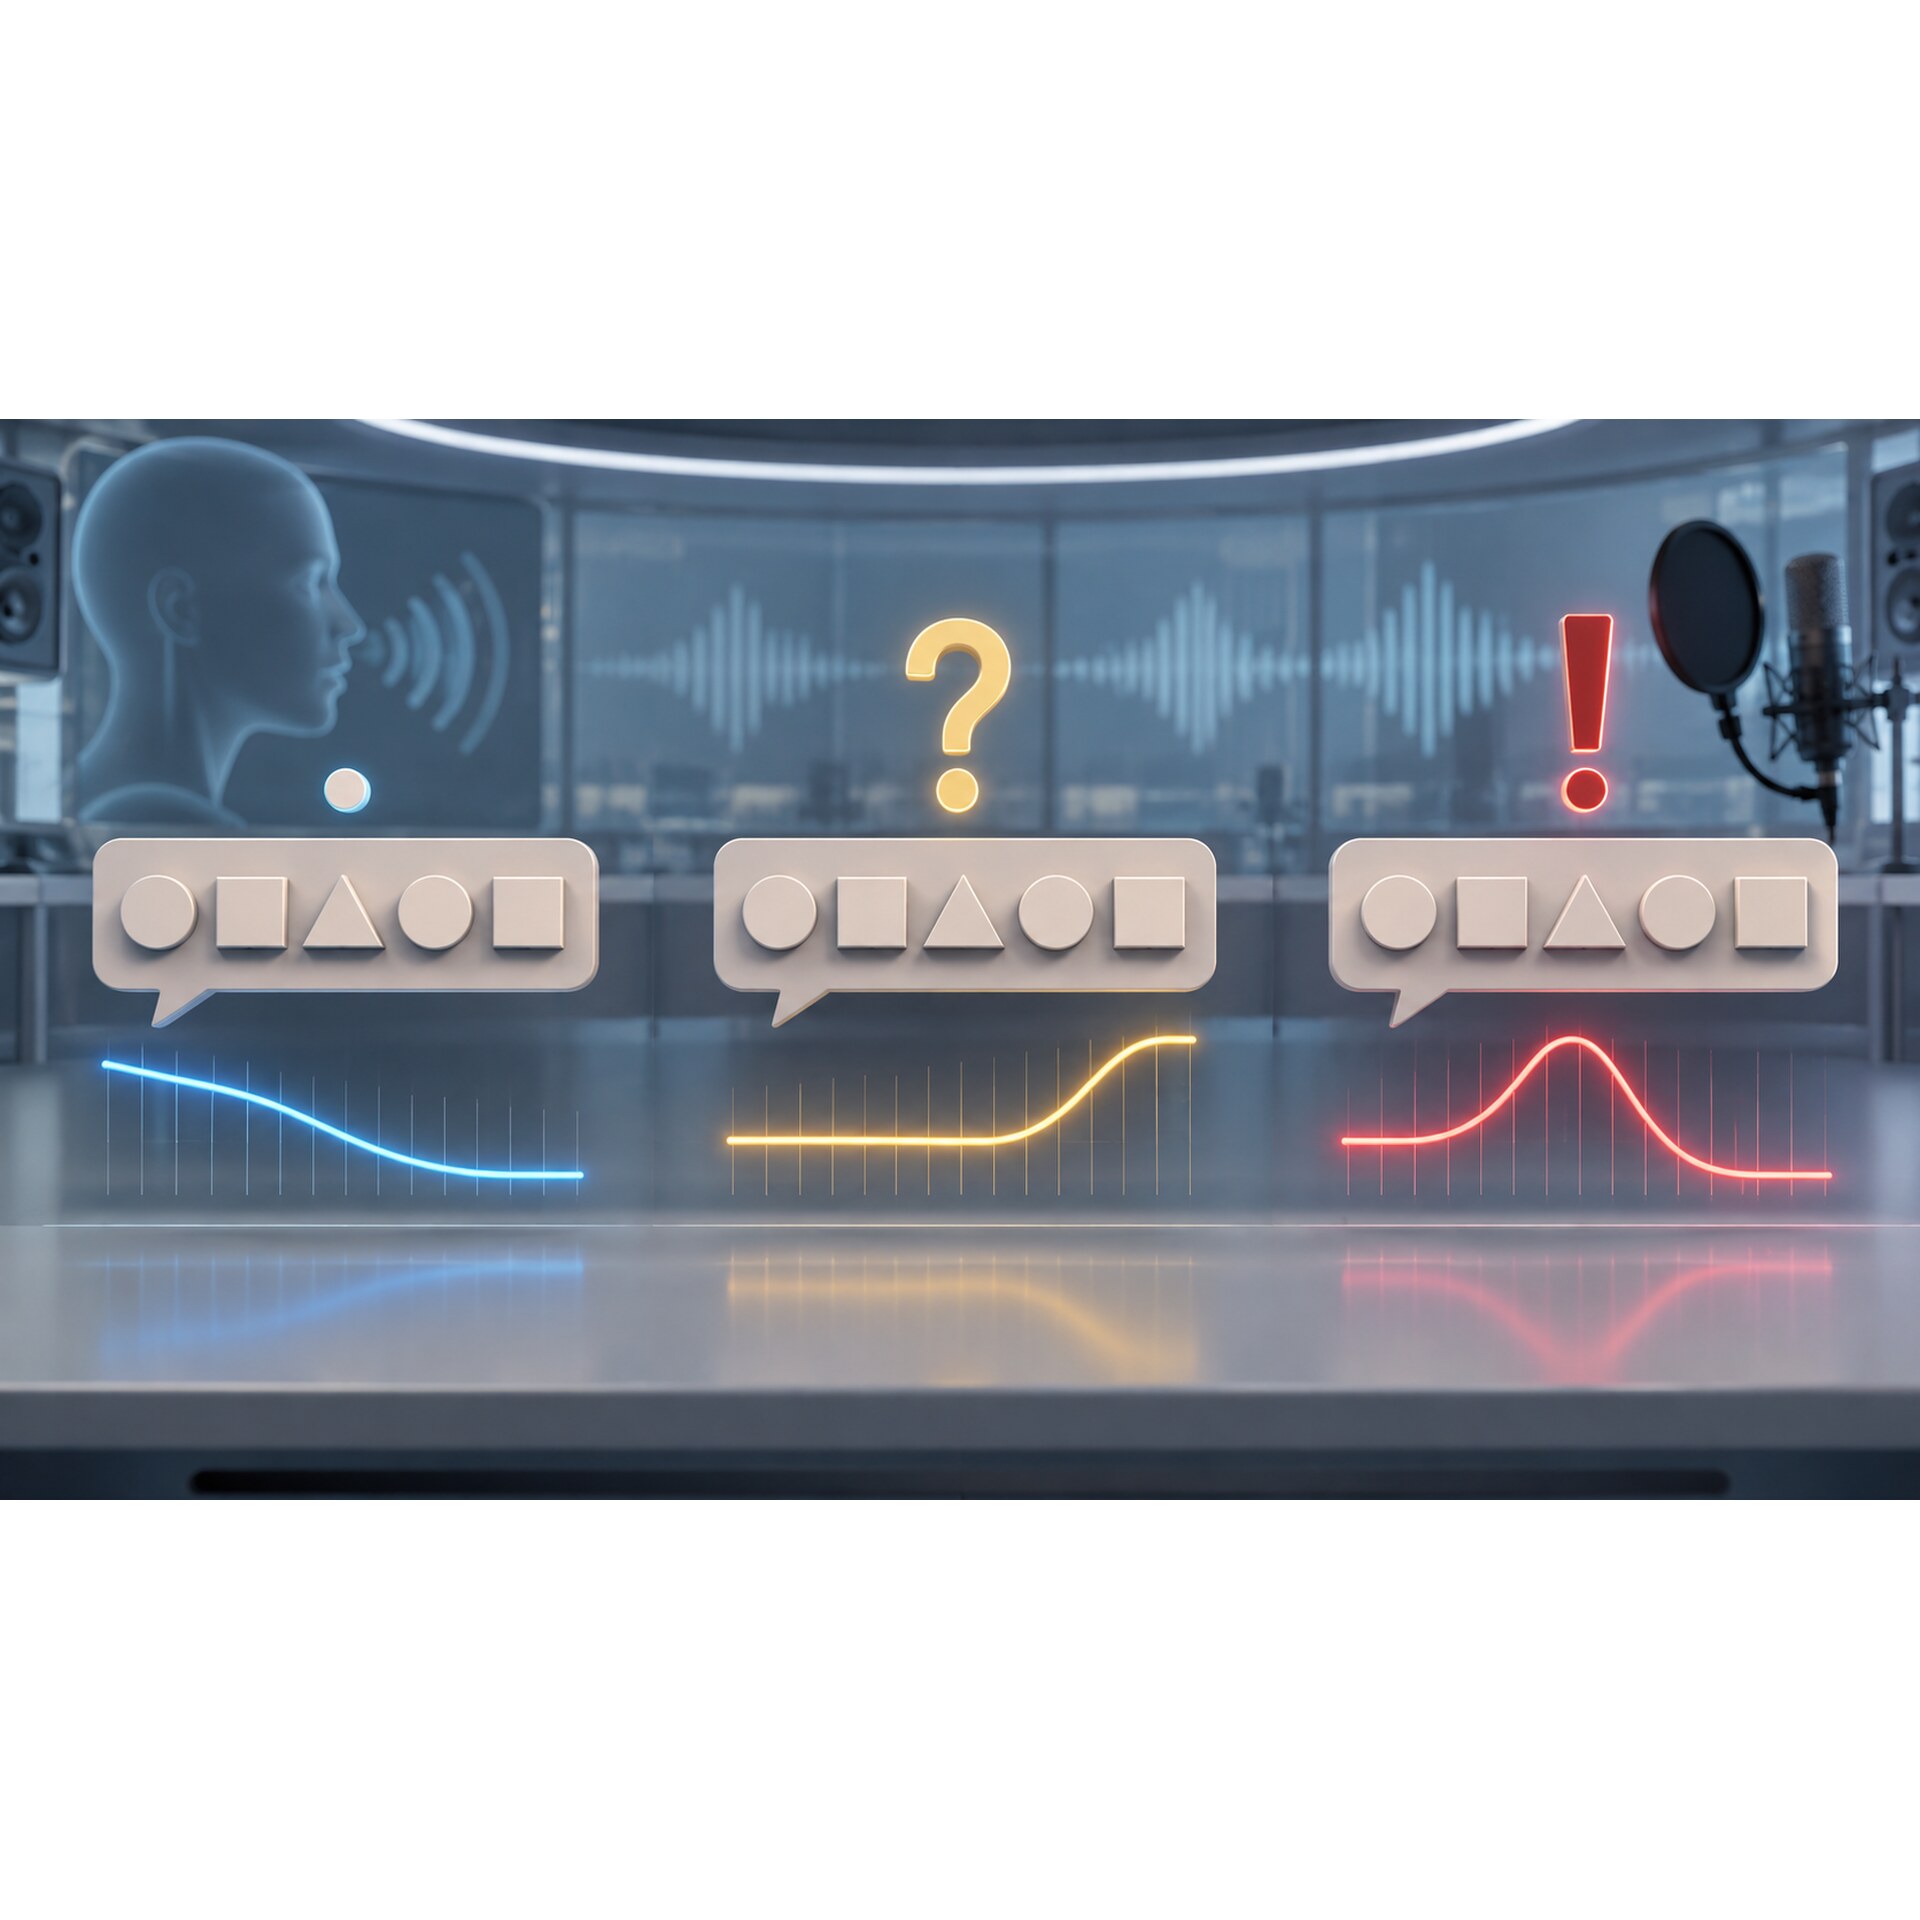
Интонация выводится из пунктуации и структуры фразы. Знака нет — интонации нет.
Риторический вопрос без знака вопроса. Фраза «Знакомая ситуация» без «?» прозвучит утверждением, и приём пропадёт.
Было: «Текст готов, а звучит неестественно. Знакомая ситуация.» → Стало: «Текст готов, а звучит неестественно. Знакомая ситуация?»
Короткий вопрос без вопросительного слова. «Это дорого?» и «Это дорого.» отличаются одним символом, а на слух — полностью: без «как» и «почему» знак остаётся единственным носителем интонации.
Обращение и прямая речь. Запятая после обращения даёт паузу и меняет контур: «Коллеги, начнём» звучит иначе, чем «Коллеги начнём». Прямую речь вводят словами «он сказал», иначе реплика сольётся с авторской.
Курсив и полужирный не работают. Синтез не видит оформления, логическое ударение начертанием не передаётся. Слово, которое нужно выделить голосом, выносится в короткую фразу.
Было: «Проблема в исходнике.» → Стало: «Проблема именно в исходнике. Не в движке.»
Что ломается, почему и как исправить: таблица разбора
| Что ломается | Почему | Как исправить в исходнике |
|---|---|---|
| Омографы: за́мок, до́рог, бо́льшая | В узком контексте нет подсказки | Пометить ударение или добавить слово: «дверной замо́к» |
| «В 2026 году» | Цифра читается количественным, падеж рассыпается | «В две тысячи двадцать шестом году» |
| 1 500 | Форма не задана: полторы тысячи или тысяча пятьсот | Записать нужный вариант словами |
| Даты вида 10.09.2026 | Точки трактуются как разделители | «Десятого сентября две тысячи двадцать шестого года» |
| Диапазоны 2020-2026, 10-19 | Тире читается как минус или игнорируется | Добавить связку: «с… по…», «с… до…» |
| Суммы и проценты: 6 990 ₽, 70 % | Символ идёт в именительном падеже | «На семьдесят процентов» |
| Телефон одной строкой | Номер звучит как одно длинное число | Разбить на группы точками или записать словами |
| Аббревиатуры и латиница: IVR, Q&A | Неясно, читать по буквам или словом | Расшифровать при первом упоминании |
| Адреса сайтов и почты | Точки, слэши и «собака» читаются буквально | Переписать маршрутом, адрес — в описание |
| Предложение на 40 слов | Один интонационный контур, пауз внутри нет | Разбить на фразы по 12-15 слов |
| Риторический вопрос без «?» | Интонация выводится только из пунктуации | Поставить знак или перестроить фразу |
Настройки сервиса, форматы файлов и скорость обработки текста
Вычитка снимает большую часть проблем, остальное правится настройками: доступны скорость и темп, паузы, интонация, ударения, тон и стиль, тембр, эмоциональность. Смысловые ошибки лечатся в тексте, характер звучания — настройками.
Скорость и темп подбираются под задачу: инструкция звучит медленнее рекламы.
Паузы добавляют остановку там, где пунктуация её не даёт. Заменять ими правку исходника не стоит: в длинном тексте это превратится в ручную расстановку знаков.
Интонация, тон и стиль задают регистр: нейтральный для справки, тёплый для приветствия. Тембр и эмоциональность отвечают за характер голоса; как описать нужный тембр словами, разобрано в отдельном материале блога.
Форматы. На входе текст загружается файлом .txt и .docx, на выходе доступны MP3 и WAV. Перед загрузкой .docx стоит убрать сноски, колонтитулы и подписи к картинкам — они попадут в озвучку наравне с основным текстом.
Скорость. Короткий текст до 1 000 символов обрабатывается меньше чем за 5 секунд — на этом и держится проверка по фрагментам.
Голоса и языки. Доступны 60 языков и 45 диалектов, более 30 голосов, есть бесплатные и премиум-голоса. По калькулятору на 10 сентября 2026 года разовая озвучка указана как 0 ₽, вариант с тарифом — 20 ₽; состав пакетов и лимиты уточняются в сервисе. Подобрать голос под русскоязычный материал удобнее на странице синтеза речи на русском языке, а полный набор инструментов собран в разделе ИИ-сервисов платформы.
Чек-лист вычитки перед генерацией: десять пунктов
Порядок имеет значение: сначала то, что ломает смысл, потом то, что портит ритм.
- Прогнать поиск по омографам. Список выше плюс отраслевые слова: пометить или переписать.
- Проверить имена собственные. Фамилии, города и названия компаний слушаются отдельно.
- Перевести числа в слова там, где важен падеж. Годы, порядковые числительные, суммы в косвенных падежах.
- Раскрыть даты и диапазоны. Записей вида 10.09.2026 и 2020-2026 остаться не должно.
- Разобрать деньги, проценты, дроби и телефоны. Символы заменяются словами, номер — на группы.
- Разметить аббревиатуры. Первое упоминание — расшифровка, дальше сокращение.
- Убрать адреса и почту из речи. Ссылка уходит в описание, в тексте остаётся маршрут словами.
- Разрезать длинные предложения. Ориентир 12-15 слов, обороты и скобки — в самостоятельные фразы.
- Проставить знаки интонации. Вопросительные знаки, точки в заголовках, запятые после обращений.
- Прогнать тестовый фрагмент. Абзац с самой плотной фактурой слушается первым и целиком.
Одиннадцатый пункт неформальный: прочитать текст вслух самому — всё, на чём спотыкается человек, споткнёт и синтез. Как вычитка встраивается в подготовку сценария, показано в разборе озвучивания обучающих материалов.
Когда подготовка текста не спасёт озвучку
Вычитка решает механические проблемы произношения. Есть задачи, где она бесполезна, и честнее знать об этом заранее.
Плохо написанный текст. Синтез не сделает канцелярит живым и не спасёт сценарий без структуры. Если материал скучно читать глазами, вслух он звучит хуже.
Актёрская игра. Сарказм, подтекст, смена состояния внутри реплики — работа диктора, а не настройка. Художественный дубляж и имиджевая реклама, где голос сам по себе часть бренда, остаются за живым исполнителем.
Права и коммерческое использование. Использовать готовое аудио в коммерческом проекте можно, только если это разрешено условиями модели и тарифа. Для чужих голосов и загруженных образцов дополнительно требуется право на исходную запись. Работать следует с материалами, на которые есть права; создавать поддельные рекомендации и обращения и приписывать реальному человеку чужие слова нельзя — редактурой исходника это ограничение не обходится.
Проверка перед объёмом. Возможность попробовать бесплатно зависит от тарифа и выбранной модели. Порядок такой: короткое превью, проверка актуальных лимитов и только затем генерация всего проекта. Прогнать проверочный фрагмент можно в сервисе озвучки текста за одну генерацию.
FAQ: ии озвучка текста — ударения, числа, паузы и права
Как пометить ударение, если знак не поддерживается?
Переписать фразу так, чтобы двойного чтения не осталось: добавить уточняющее слово или заменить синонимом. Плюс настройка ударений в сервисе.
Почему одно и то же слово в двух местах читается по-разному?
Движок опирается на ближайшие слова: рядом с подсказкой выбор верный, в нейтральном контексте результат может отличаться даже между двумя генерациями.
Как записать 1 500, чтобы прозвучало «полторы тысячи»?
Написать словами: цифровая запись формы не содержит, и вариант выбирает движок. То же в косвенных падежах — «полутора тысячам».
Нужно ли писать словами все числа подряд?
Нет. Количественные числительные в именительном падеже читаются корректно. Переписывать нужно годы, порядковые числительные, суммы, проценты, дроби, даты и диапазоны.
Как заставить синтез сделать паузу там, где нет знака препинания?
Поставить точку вместо запятой, вынести мысль в абзац или добавить паузу настройкой. Первые два способа надёжнее: они переносятся вместе с текстом.
Что делать с аббревиатурами, которых нет в словарях?
Раскрывать при первом упоминании и дальше использовать сокращение. Если оно встречается один-два раза, проще заменить полным названием.
Почему риторический вопрос звучит как утверждение?
Интонация выводится из пунктуации: без знака вопроса фраза получает нисходящий контур завершённости. Достаточно поставить «?» или добавить вопросительное слово.
В каком формате загружать текст и что получится на выходе?
На входе принимаются файлы .txt и .docx, на выходе доступны MP3 и WAV. Из документа стоит убрать сноски, колонтитулы и подписи к иллюстрациям.
Сколько времени занимает проверочная генерация?
Короткий текст до 1 000 символов обрабатывается меньше чем за 5 секунд, поэтому фрагменты проверять выгоднее, чем документ целиком.
Можно ли использовать полученную дорожку в рекламе?
Только если это разрешено условиями модели и тарифа, а для чужих голосов и загруженных образцов нужно право на исходную запись.
Итог: ии озвучка текста — что вычитать до кнопки
Качество звучания определяется исходником. Пять классов правок закрывают почти все типовые поломки: ударения и омографы, числа во всех формах, аббревиатуры и латиница, паузы и ритм, знаки интонации. Настройки доводят звучание, но не чинят смысл.
Рабочий порядок: вычитать по чек-листу, прогнать самый плотный абзац превью, поправить исходник и только потом генерировать весь материал. Загрузка идёт файлом .txt или .docx, выгрузка в MP3 или WAV, фрагмент до 1 000 символов обрабатывается меньше чем за 5 секунд.
Ограничения тоже стоит держать в голове: канцелярит, актёрская игра и художественный дубляж редактурой не лечатся, а коммерческое использование возможно, только если это разрешено условиями модели и тарифа. Цифры и условия сверены 10 сентября 2026 года и перепроверяются перед запуском проекта — актуальные тарифы и голоса видны в интерфейсе ИИ-озвучки.
Читайте также: TTS: что это, как работает синтез речи и как подготовить текст и тембр голоса: что это, от чего зависит и как описать его для озвучки.